Treinada com 111 mil imagens sintéticas, a rede isola o subanel que guarda a assinatura da rotação do buraco negro e se prepara para as fotos da missão BHEX
A ferramenta é uma rede neural convolucional, e quem a construiu foi um trio de pesquisadores da Universidade da Califórnia: Courtney Duong e Frank Myhre, do Departamento de Física do campus de Santa Barbara, e Joseph R. Farah, do Instituto Miller de Pesquisa Básica em Ciência e do Departamento de Astronomia do campus de Berkeley. O artigo, intitulado Convolutional Neural Network for Extraction of n = 1 Photon Ring of Black Holes, foi depositado no repositório arXiv em 21 de setembro de 2026, na categoria de instrumentação e métodos para astrofísica, com versão de rascunho datada de 23 de setembro. A promessa é direta: ensinar um algoritmo a separar, pixel a pixel, o subanel de fótons de ordem um da emissão dominante de ordem zero, preservando as propriedades físicas que permitem medir a rotação de um buraco negro.
Para entender por que isso importa, é preciso voltar a abril de 2019, quando o Telescópio do Horizonte de Eventos, o EHT, divulgou a primeira imagem direta de um buraco negro, o gigante de 6,5 bilhões de massas solares no centro da galáxia M87. Três anos depois, em maio de 2022, veio a imagem de Sagitário A*, o buraco negro de cerca de 4 milhões de massas solares no coração da Via Láctea. As duas fotografias foram obtidas com a técnica de very-long-baseline interferometry, a interferometria de linha de base muito longa, conhecida pela sigla VLBI, que combina os sinais de radiotelescópios espalhados por continentes diferentes para simular uma antena virtual do tamanho da Terra. O que se viu em ambas foi um anel brilhante e assimétrico envolvendo uma região escura, a sombra do buraco negro.
A resolução angular dessas imagens, da ordem de 20 microssegundos de arco, equivale a ler um jornal em Nova York a partir de uma calçada em Paris. É um feito técnico monumental, mas ainda insuficiente para enxergar a estrutura mais fina prevista pela relatividade geral nas vizinhanças do horizonte. O anel que o EHT registrou é, na verdade, uma superposição borrada de várias componentes: a luz emitida diretamente pelo gás quente que gira ao redor do buraco negro e a luz que foi curvada pela gravidade de maneira extrema antes de chegar até nós. A separação entre essas camadas exige um salto de resolução que os telescópios terrestres, limitados pelo diâmetro do planeta, não conseguem dar. É aí que entra a proposta de levar a interferometria para a órbita.
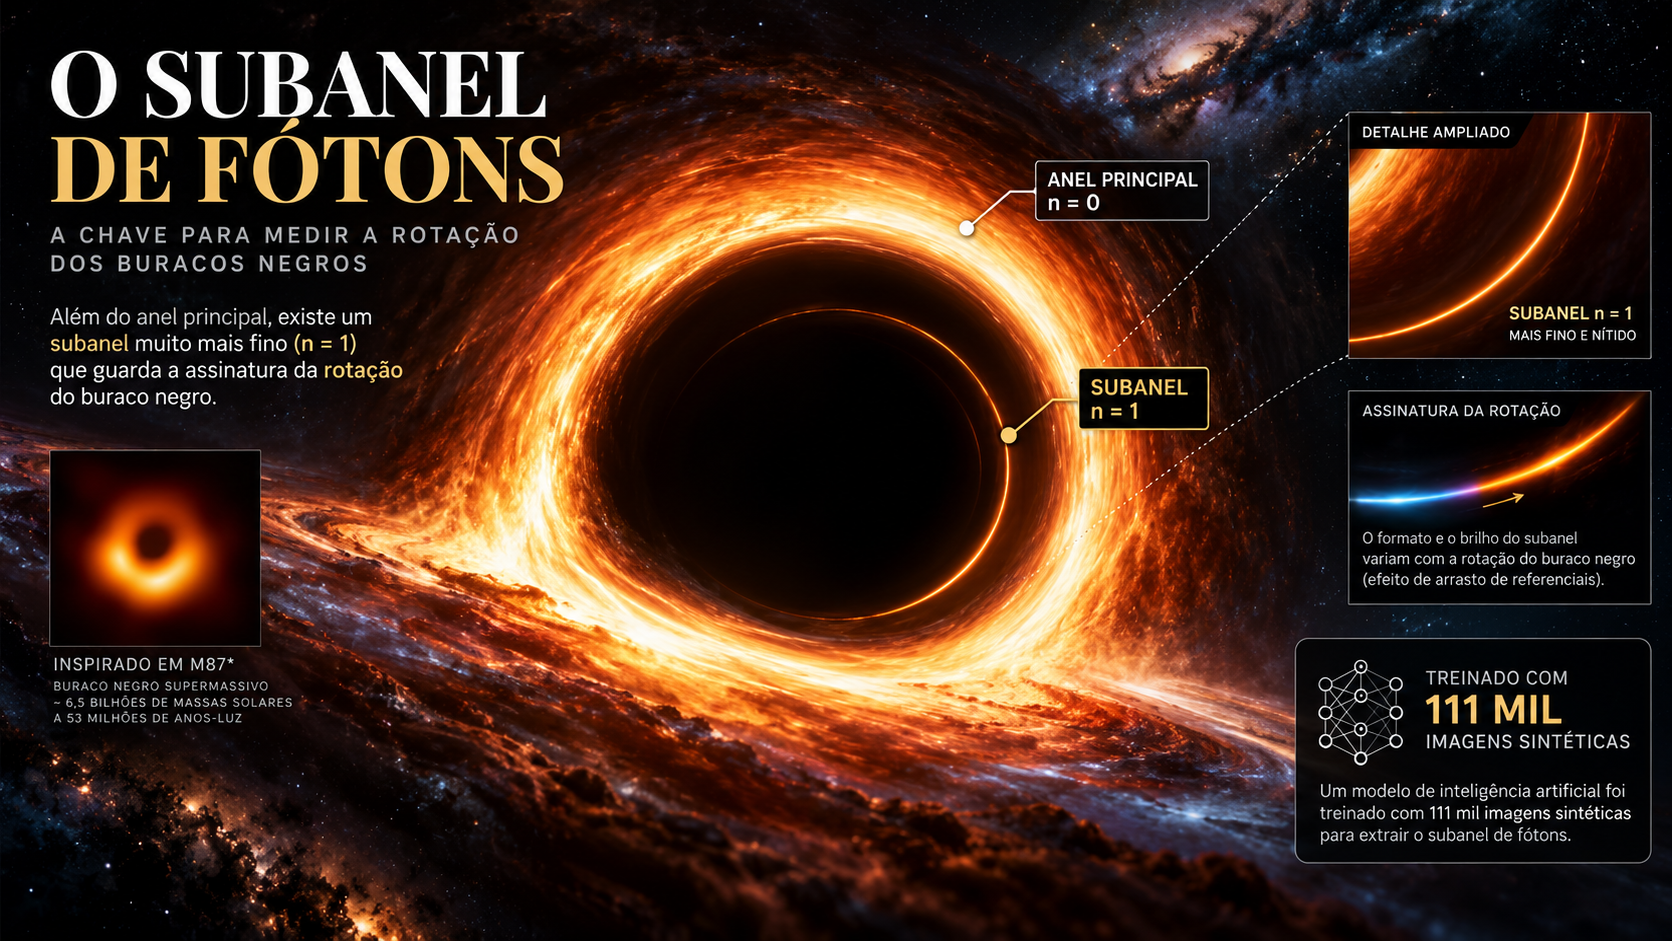
A estrutura em questão é o photon ring, o anel de fótons, uma previsão da relatividade geral que remonta às primeiras simulações de Jean-Pierre Luminet, em 1979, e que foi formalizada com rigor matemático por Michael Johnson e colaboradores em 2020 e por Samuel Gralla e Alexandru Lupsasca no mesmo ano. Ao redor de todo buraco negro existe uma casca de órbitas instáveis onde a luz pode circular muitas vezes antes de cair ou escapar. Fótons que passam perto dessa casca completam meias-voltas em torno do objeto antes de seguir rumo ao observador, e o número de meias-voltas define a ordem do subanel. O subanel de ordem zero, ou n = 0, é formado pela luz que vem direto da fonte. O de ordem um, n = 1, pela luz que deu meia volta. O de ordem dois, pela que completou uma volta inteira, e assim por diante.
Cada subanel sucessivo é exponencialmente mais estreito e mais tênue do que o anterior. No caso mais simples, o de um buraco negro sem rotação visto de frente, a largura e o brilho caem por um fator próximo de 23 a cada ordem, o número e elevado a pi. Isso significa que o subanel n = 1 é uma fatia delgadíssima de luz, com uma fração minúscula da largura do anel principal, e o n = 2 já se torna praticamente invisível para qualquer instrumento concebível nas próximas décadas. Os autores do novo estudo partem exatamente dessa hierarquia: nas imagens futuras, a contaminação relevante virá do n = 0, e as contribuições de ordem igual ou superior a dois serão desprezíveis. O desafio prático se resume, portanto, a separar duas camadas sobrepostas.
O que torna o n = 1 tão valioso é a origem física de sua forma. O subanel n = 0 é moldado principalmente pelo fluxo do plasma: onde o gás está mais quente, mais denso ou se movendo em nossa direção, o brilho aumenta, e essas variações dependem da turbulência, do campo magnético e do instante em que se observa. Os subanéis de ordem igual ou superior a um, ao contrário, são esculpidos pelo próprio espaço-tempo. A literatura recente mostra que o n = 1 codifica a rotação do buraco negro em duas assinaturas: o perfil radial, ou seja, o raio do anel medido em cada direção, e a modulação azimutal do brilho, a maneira como a intensidade varia ao longo da circunferência. Ambas podem ser descritas de forma aproximada por uma figura geométrica batizada de m-ring, um anel cuja espessura e cujo brilho variam com o ângulo segundo uma soma de harmônicos.
Vários grupos já demonstraram, ao menos em simulações, que a rotação pode ser extraída da imagem direta do n = 1: Broderick e colegas em 2022, Palumbo e Wong no mesmo ano, Paugnat e colaboradores em 2022, Chang e equipe em 2024, Farah e colaboradores em 2024 e 2025, e Keeble e colegas em 2025. Todos esses métodos pressupõem que o subanel esteja resolvido. A resolução projetada da missão Black Hole Explorer, o BHEX, deve ser suficiente para isso tanto em M87* quanto em Sagitário A*, o que faz da missão o cenário natural para estudar os desafios de análise de imagem envolvidos. O BHEX estenderia o EHT ao espaço, acrescentando uma antena em órbita à rede terrestre, e melhoraria a resolução angular das imagens diretas dos atuais 20 microssegundos de arco para até 6.
Seis microssegundos de arco é um ângulo tão pequeno que, se o olho humano o enxergasse, distinguiria dois grãos de arroz lado a lado na superfície da Lua. Para alcançá-lo, a antena orbital precisa ficar a uma distância das estações terrestres maior do que o diâmetro do planeta, porque em interferometria a resolução cresce com a separação entre os receptores. Essa distância extra é o que abre a janela para o anel de fótons, que fica apenas um pouco além do que o EHT já alcança. O ganho de um fator três não parece dramático em palavras, mas é o que separa uma mancha difusa de uma estrutura com bordas definidas, e é nessa diferença que mora a possibilidade de medir a rotação.
O obstáculo, mesmo com o BHEX, é que o n = 1 não aparece sozinho. Ele se sobrepõe espacialmente à emissão do n = 0, que é cerca de dez vezes mais larga e, na maior parte das configurações realistas, mais brilhante. É como tentar ouvir uma única flauta em meio a uma orquestra inteira tocando a mesma nota: a melodia está lá, mas a parede de som a envolve por todos os lados. Em termos de pixels, cada ponto da imagem recebe luz das duas componentes misturadas, e não existe um filtro simples, como um corte em cor ou em frequência, capaz de desfazer a mistura. Isolar o subanel exige reconhecer sua forma como um todo, e é esse tipo de reconhecimento de padrões que as redes neurais convolucionais fazem bem.
A estratégia dos autores foi tratar o problema como uma tradução de imagem para imagem. A rede recebe uma figura composta, contendo os dois subanéis, e devolve outra figura do mesmo tamanho contendo apenas o n = 1. Para aprender essa tradução, ela precisa ver muitos exemplos em que a resposta correta é conhecida, o que só é possível com dados simulados, já que nenhuma observação real resolveu o anel de fótons até hoje. Depois do treinamento, a qualidade das extrações foi medida com o ringfit, um programa de extração de características desenvolvido por Myhre e Farah em 2025, que mapeia o perfil radial e o perfil angular de brilho de qualquer imagem em forma de anel. O trabalho se apresenta, nas palavras da equipe, como uma prova de conceito robusta.
O conjunto de treinamento foi gerado com o modelo m-ring do pacote eht-imaging, a biblioteca em Python mantida por Andrew Chael e usada pela própria colaboração EHT para simular e reconstruir imagens interferométricas. Ao todo, foram produzidas mais de 111 mil figuras sintéticas, cada uma com 128 por 128 pixels, contendo apenas intensidade, com os valores normalizados entre zero e um. Todas as imagens são expressas em unidades de raio gravitacional, o M, em vez de microssegundos de arco. A escolha não é cosmética: o raio gravitacional é o produto da constante gravitacional pela massa do buraco negro dividido pelo quadrado da velocidade da luz, e usá-lo como régua torna a análise independente da massa e da distância específicas de qualquer objeto.

A razão está na geometria da observação. Aumentar a massa de um buraco negro amplia seu tamanho físico, enquanto aumentar a distância reduz seu tamanho aparente, de modo que apenas a razão entre massa e distância determina o ângulo que ele ocupa no céu. Um anel de 10 M pode pertencer a um buraco negro de milhões de massas solares relativamente próximo ou a um de bilhões de massas solares a dezenas de milhões de anos-luz, e a rede não precisa saber qual é o caso. Quando é preciso converter para ângulos, os autores adotam a razão massa-distância de M87* estimada pelo EHT, para a qual cada unidade M corresponde a pouco menos de 4 microssegundos de arco. Nessa escala, a sombra do buraco negro, com cerca de 10 M de diâmetro, ocupa pouco menos de 40 microssegundos de arco, e o anel brilhante registrado pelo EHT, ligeiramente maior, mede 42.
Um detalhe de projeto chama a atenção: o espaço de parâmetros das simulações foi deliberadamente ampliado para além do que se espera de buracos negros reais. Modelos de buracos negros de Kerr, a solução das equações de Einstein para objetos em rotação, com raios de emissão entre 3 M e 7 M, mostram que o tamanho e a morfologia do n = 1 variam com a rotação e com a inclinação do eixo em relação à linha de visada. O conjunto de treinamento, em comparação, permite diâmetros de 7,0 M a 10,5 M para o n = 0 e de 8,4 M a 10,0 M para o n = 1, com intensidades de assimetria de brilho que vão de zero a 0,4 para ambos. A ideia é expor a rede a configurações mais extremas do que as da natureza, para que as realistas, que ocupam um subconjunto estreito desse espaço, sejam tratadas com folga.
Os valores concretos ajudam a visualizar a hierarquia entre as duas componentes. Para o n = 0, os fluxos simulados foram de 0,5, 0,65 e 0,8 jansky, a unidade de densidade de fluxo usada em radioastronomia, com larguras de 1,3, 1,6 e 2,0 M. Para o n = 1, os fluxos foram de 0,02, 0,51 e 1,0 jansky, com larguras de apenas 0,1, 0,3 e 0,4 M. Ambos os subanéis receberam deslocamentos horizontais de zero, 0,3 e 0,7 M, ângulos de assimetria de zero, 90 e 180 graus e intensidades de assimetria de zero, 0,2 e 0,4. O anel principal é, portanto, cerca de dez vezes mais largo do que o subanel que se quer extrair, uma proporção que reproduz a característica essencial dos anéis de fótons reais, em que cada ordem sucessiva é drasticamente mais fina do que a anterior.

A combinação dessas opções gerou cerca de 100 imagens distintas de n = 0 e cerca de 700 de n = 1, que, sobrepostas em pares, resultaram em aproximadamente 70 mil imagens compostas. A equipe então ampliou o conjunto com uma operação de aumento de dados: selecionou mil configurações em que os dois subanéis estavam alinhados e girou o n = 1 em relação ao n = 0 por 41 ângulos diferentes, de zero a 30 graus em passos de um grau, para cobrir pequenos desalinhamentos de assimetria, e de 45 a 180 graus em passos de quinze graus, para cobrir os grandes. Isso acrescentou 41 mil imagens e levou o total a 111 mil. A rotação relativa é crucial porque, na natureza, não há razão para que o setor mais brilhante do gás coincida com o setor mais brilhante do anel de fótons.
O conjunto inclui ainda imagens que contêm somente o n = 0, sem nenhum traço do subanel de ordem um. Elas têm uma função pedagógica específica: ensinar a rede a reconhecer a ausência. Sem esses exemplos, um algoritmo treinado apenas em pares completos tenderia a desenhar um anel fino em qualquer entrada, inventando uma estrutura que não existe, o fenômeno que a comunidade de aprendizado de máquina chama de hallucination, a alucinação do modelo. Em uma observação real, um falso positivo desse tipo seria desastroso, porque levaria a medir a rotação de um buraco negro a partir de uma feição fabricada pelo próprio software. Ao ver exemplos vazios durante o treinamento, a rede aprende que a resposta certa, às vezes, é uma imagem escura.
Redes neurais convolucionais são algoritmos de aprendizado em múltiplas camadas, baseados em gradiente, cuja linhagem remonta ao trabalho de Yann LeCun e colegas em 1998, no reconhecimento de dígitos manuscritos, e ao salto de desempenho obtido por Alex Krizhevsky e colaboradores em 2012 na classificação de imagens naturais. Elas aprendem características espaciais diretamente das intensidades dos pixels, de forma hierárquica: as primeiras camadas detectam bordas e gradientes simples, as intermediárias combinam essas bordas em formas, e as mais profundas reconhecem padrões complexos. Pode-se pensar em cada camada como um conjunto de lupas especializadas que varrem a imagem em busca de um motivo específico e passam adiante um mapa indicando onde o motivo foi encontrado. O custo desse poder é computacional: treinar redes em imagens de alta resolução consome tempo e memória consideráveis.
A rede do estudo foi implementada com a interface Keras do TensorFlow 2.19 e segue a arquitetura encoder-decoder, codificador-decodificador, popularizada para a redução de dimensionalidade por Geoffrey Hinton e Ruslan Salakhutdinov em 2006. O codificador comprime a imagem de entrada em uma representação compacta; o decodificador a reconstrói nas dimensões originais. Na implementação adotada, o codificador tem duas camadas convolucionais com funções de ativação e preenchimento do tipo same, que preserva o tamanho espacial, cada uma seguida por uma camada de max pooling, o agrupamento por máximo, que reduz a resolução progressivamente enquanto aumenta o número de mapas de características. Uma camada-gargalo transforma esses mapas em uma representação ainda mais condensada antes que o decodificador, espelhando a estrutura, aplique camadas de superamostragem e convolução para restaurar as dimensões. A saída final é uma convolução de um por um pixel com ativação sigmoide, que produz uma imagem do mesmo tamanho da entrada.

A lógica por trás dessa escolha é que o codificador aprende feições cada vez mais abstratas, como variações de intensidade e as bordas dos subanéis, enquanto o decodificador usa essas feições para reconstruir a posição e a estrutura do n = 1 no plano da imagem. É um processo parecido com o de um desenhista que, diante de uma fotografia confusa, primeiro identifica mentalmente os contornos essenciais e depois os redesenha em uma folha limpa, deixando de fora tudo o que não pertence ao objeto de interesse. A rede não possui nenhuma noção embutida de relatividade geral ou de geometria de Kerr; tudo o que sabe sobre anéis de fótons vem dos exemplos que viu durante o treinamento.
Com a arquitetura geral fixada, a equipe otimizou os hiperparâmetros, os ajustes que governam o aprendizado, com o Optuna, um arcabouço de otimização automática apresentado por Takuya Akiba e colegas em 2019. Foram cem tentativas, cada uma com cinquenta épocas de treinamento, e em cada tentativa o Optuna testou uma combinação diferente dentro de um espaço de busca amplo: taxas de aprendizado entre um milionésimo e um milésimo, em escala logarítmica; lotes de 8, 16, 32 ou 64 imagens; cinco funções de perda distintas, a entropia cruzada binária, o erro quadrático médio, o erro absoluto médio, um filtro de Sobel e o índice de similaridade estrutural; dois otimizadores, Adam e AdamW; 32 ou 64 filtros na primeira camada, 64 ou 128 na segunda e 128 ou 256 na terceira; núcleos de convolução de três por três ou de cinco por cinco; e três funções de ativação, ReLU, Leaky ReLU e GELU.

A configuração vencedora, escolhida por minimizar a perda no conjunto de validação, usa o erro quadrático médio como função de perda, o otimizador AdamW proposto por Ilya Loshchilov e Frank Hutter em 2019, uma taxa de aprendizado de 1,94 × 10⁻⁴, lotes de 16 imagens, filtros na sequência 32-128-128, núcleos de três por três pixels e a ativação Leaky ReLU, uma variante da unidade linear retificada que deixa passar uma pequena fração dos valores negativos. Do conjunto total, 80% das imagens foram destinadas ao treinamento e 20% à validação. O treinamento segue o esquema clássico de LeCun: os pesos e vieses da rede são atualizados iterativamente ao longo das épocas para reduzir a discrepância entre as previsões e as imagens de referência, e as funções de ativação não lineares em cada camada permitem que o modelo capture relações complexas entre os pixels.
Para medir o sucesso, os autores recorreram à correlação cruzada normalizada, a NXcorr, uma métrica que a colaboração EHT utilizou em 2019 para comparar reconstruções e que Farah e colegas aplicaram em 2022 para identificar as porções de uma imagem que mais se aproximam de um modelo. Ela compara, pixel a pixel, os desvios de intensidade de duas imagens em relação às respectivas médias, normalizados pelos desvios-padrão, e devolve um número entre zero e um: um valor igual a um indica concordância estrutural perfeita, e um valor próximo de zero indica pouca ou nenhuma semelhança. O teste consistiu em comparar a previsão da rede com a imagem verdadeira do n = 1, a chamada ground truth, a verdade de referência, e confrontar esse resultado com a semelhança entre a imagem de entrada composta e a mesma referência.

Antes de calcular a métrica, a equipe filtrou dois tipos de caso. O primeiro foram as amostras sem n = 1, nas quais a imagem de referência é inteiramente zero, de modo que qualquer ruído mínimo na previsão produziria valores baixos de similaridade sem refletir o desempenho real. O segundo foram as imagens em que o n = 1 já dominava a cena e o n = 0 era comparativamente tênue, casos fáceis demais para serem informativos. A razão para essa dominância é sutil: os perfis radiais dos subanéis são aproximadamente gaussianos e, para um fluxo fixo, o pico de intensidade de uma gaussiana cresce à medida que ela se estreita. Como o n = 0 é cerca de dez vezes mais largo, o n = 1 pode ter um pico substancialmente mais alto mesmo com fluxo total menor. O fluxo, sozinho, não determina qual componente se destaca na imagem.
Com o foco colocado nos casos difíceis, aqueles em que o sinal do n = 1 precisa ser recuperado na presença de um n = 0 brilhante, os histogramas resultantes contam a história em um relance. A comparação entre as previsões da rede e as imagens de referência produz uma distribuição estreita e aguda, com média de 0,99. A comparação entre as imagens de entrada e as mesmas referências gera uma distribuição larga, centrada em 0,56. A diferença entre os dois números é a medida do trabalho que a rede faz: ela parte de uma figura que se parece pouco com o alvo e devolve outra que é quase indistinguível dele. Nos termos da equipe, a rede reconstrói o n = 1 com precisão consistente ao longo de todo o conjunto de validação.

As imagens de diferença, obtidas subtraindo a previsão da referência, deixam ver onde o modelo erra. Os resíduos se concentram em regiões pequenas de desvio de intensidade, sem feições estruturadas, o que indica que a rede recupera as características radiais e angulares dominantes do subanel. Um resultado particularmente relevante é que a modulação azimutal do n = 1 é extraída corretamente mesmo quando o n = 0 da imagem composta possui uma assimetria de brilho diferente, apontando para outro lado. Em um dos exemplos apresentados, o anel principal tem o setor mais brilhante a zero grau e o subanel a 16 graus; em outro, a zero e a 135 graus. A rede distingue as duas orientações sem contaminar uma com a outra, que é justamente a capacidade de que uma medida de rotação depende.

Para quantificar essa habilidade, os pesquisadores consideraram todas as imagens com assimetria de brilho no n = 1 e calcularam, para cada uma, a diferença entre o ângulo verdadeiro de intensidade máxima e o ângulo previsto. O resultado é que 93% das recuperações se agrupam em torno de zero grau de diferença, com dispersão de 4,1 graus para as pequenas assimetrias, de zero a 30 graus, e de 4,6 graus para as grandes, de 45 a 180 graus. Para efeito de comparação, 4 graus é o ângulo que o ponteiro dos minutos de um relógio percorre em cerca de quarenta segundos. A orientação do setor mais brilhante do anel de fótons está ligada à direção do eixo de rotação projetado no céu, e acertá-la com essa precisão é um passo necessário para qualquer inferência de spin.

O ringfit forneceu a verificação mais fisicamente significativa. Aplicado às imagens de entrada, às referências e às previsões, o programa traça duas curvas para cada uma: o raio do anel em função do ângulo e a intensidade relativa em função do ângulo. Nas amostras analisadas, as curvas extraídas da previsão da rede acompanham de perto as da referência, e não as da entrada composta, confirmando que a geometria e a estrutura de intensidade do n = 1 foram recuperadas. Há uma ressalva que os autores fazem questão de registrar: em uma das amostras, a previsão apresenta um deslocamento de intensidade quase uniforme em relação à referência. O padrão de assimetria está correto, mas a intensidade recuperada é mais baixa, o que revela que a rede pode introduzir um viés pequeno, porém sistemático, ao longo de todo o anel.

A segunda funcionalidade da rede é, nas palavras da equipe, adicional mas poderosa: ela funciona como um detector. Quando a imagem de entrada contém apenas o n = 0, a saída é essencialmente escura, sem nenhuma estrutura em forma de anel, mesmo para anéis principais com assimetria forte ou deslocados do centro. Para observações futuras, essa propriedade é decisiva, porque reduz os falsos positivos e garante que as medidas de rotação sejam derivadas do anel de fótons, e não da emissão dominante do gás. Mais do que isso, a capacidade de impor limites à própria presença do n = 1, somada à medida de sua morfologia, abre caminho para testes de hipótese nula da relatividade geral.

A ideia de um teste de hipótese nula merece uma pausa. A relatividade geral prevê que todo buraco negro possui um anel de fótons com uma estrutura de subanéis específica, cuja forma depende apenas da massa, da rotação e da inclinação. Se um instrumento com resolução suficiente apontar para M87* e um algoritmo confiável não encontrar o n = 1 onde a teoria manda, ou encontrá-lo com um tamanho ou uma forma incompatíveis, a discrepância não poderá ser atribuída à astrofísica do gás, porque o subanel é pouco sensível a ela. Seria uma indicação de que a teoria da gravitação precisa de reparos justamente no regime de campo forte, onde ela nunca foi testada com imagens. Um detector que não alucina é, nesse sentido, tão importante quanto um extrator que acerta.
Treinar e validar com o mesmo tipo de imagem sintética é apenas metade do caminho. Para testar a generalização, os autores submeteram a rede a dois tipos de imagem que ela nunca tinha visto. O primeiro veio do KerrBAM, um motor de simulação semianalítico desenvolvido por Palumbo e Wong em 2022, que calcula a aparência de um buraco negro de Kerr com um modelo simplificado de emissão. O segundo veio de simulações magnetoidrodinâmicas relativísticas gerais, conhecidas pela sigla GRMHD, que resolvem numericamente as equações do plasma magnetizado no espaço-tempo curvo e são o padrão-ouro da área, com códigos desenvolvidos por Jason Dexter, Monika Mościbrodzka, Ben Ryan, Jordy Davelaar, Andrew Chael e colaboradores ao longo da última década. Todas foram computadas em 128 por 128 pixels, a mesma resolução do treinamento.

A equipe se concentrou em modelos de disco magneticamente detido, os magnetically arrested disks, ou MAD, um regime proposto por Gennady Bisnovatyi-Kogan e Alexander Ruzmaikin em 1976 e desenvolvido por Ramesh Narayan e colegas em 2003, no qual o campo magnético acumulado perto do horizonte fica forte o bastante para frear a queda do gás. Os modelos alternativos, os SANE, de evolução normal e padrão, descritos por Narayan e colaboradores em 2012, foram excluídos deliberadamente: sua emissão pronunciada fora do eixo e fora do plano equatorial introduz uma complexidade que exigiria treinamento adicional para que o n = 1 fosse modelado com precisão. É uma escolha honesta sobre os limites atuais do método, e não uma afirmação de que os modelos MAD descrevem melhor a natureza, embora a colaboração EHT tenha favorecido esse regime para M87* em sua análise de polarização de 2021.
As imagens do KerrBAM foram geradas para um buraco negro de rotação alta e baixa inclinação, com parâmetro de spin igual a 0,8 e eixo inclinado em 17 graus em relação à linha de visada, o valor escolhido para reproduzir M87*. A rede foi testada em duas versões de cada imagem: a original e a convoluída com o feixe nominal do BHEX, isto é, borrada para simular a resolução finita do instrumento. Nas duas, o perfil radial do n = 1 previsto acompanha, em linhas gerais, o da referência. Nas imagens convoluídas, porém, a rede tem dificuldade em recuperar o perfil de intensidade: a variação azimutal de brilho prevista difere significativamente da verdadeira e parece enviesada pela extração da própria imagem de entrada. A conclusão dos autores é que será preciso treinar com uma variedade mais ampla de resoluções angulares.

Nas simulações GRMHD, a rede encarou três cenários. O primeiro é a imagem média no tempo de um buraco negro com spin 0,5, com o parâmetro de aquecimento de elétrons fixado em 40 no disco fracamente magnetizado e em 1 no jato fortemente magnetizado, uma prescrição que controla quanto da energia da turbulência vai para os elétrons que emitem a radiação observada. O segundo é a média temporal de um buraco negro com spin 0,9375 e aquecimento de 80 no disco e 1 no jato. Nos dois casos, a rede limpa boa parte da emissão difusa e captura qualitativamente a estrutura radial e o padrão de assimetria do n = 1 presente na entrada. O terceiro cenário é um único instantâneo, um snapshot, da segunda simulação, no qual feições transitórias de curta duração povoam a imagem.

No instantâneo, as inconsistências de intensidade são maiores e os detalhes finos são recuperados com menos fidelidade, o que, segundo os pesquisadores, indica a necessidade de treinar com imagens desse tipo. O balanço geral dos testes de generalização é equilibrado. Inconsistências de intensidade aparecem em todas as aplicações a KerrBAM e GRMHD, mas os subanéis previstos exibem feições coerentes com o que se espera dessas configurações de buraco negro, e a rede produz extrações significativas em simulações que nunca viu, inclusive quando a verdadeira estrutura do n = 1 não é conhecida de antemão. Para um algoritmo que só conheceu anéis geométricos idealizados, reconhecer o subanel em meio à turbulência de um plasma simulado é um sinal de que aprendeu algo mais geral do que a forma dos exemplos.
O lugar deste trabalho no panorama mais amplo fica claro quando se olha para a abordagem concorrente. Desde o artigo de Johnson e colaboradores em 2020, a estratégia dominante para detectar o anel de fótons opera no domínio das visibilidades, as quantidades que um interferômetro mede diretamente, e tira proveito do fato de que, em linhas de base muito longas, a assinatura periódica do subanel estreito domina sobre a emissão difusa do n = 0. A rede neural de Duong, Myhre e Farah oferece um caminho ortogonal: em vez de sondar as linhas de base onde o n = 1 domina, remove a emissão do n = 0 da própria imagem. As duas vias podem se complementar, e a concordância entre elas seria um teste de robustez difícil de obter com qualquer uma isoladamente.
A ideia de usar aprendizado profundo em imagens de buracos negros não é nova. Van der Gucht e colegas, em 2020, treinaram redes para recuperar parâmetros de simulações GRMHD, e Farah e colaboradores, em 2024, desenvolveram uma inferência de momento angular baseada em aprendizado de máquina para observações do n = 1 pelo BHEX. O que o novo trabalho acrescenta é a separação de componentes como etapa intermediária. Uma vez isolado o subanel estreito, livre da contaminação do n = 0, ele pode alimentar essas mesmas ferramentas de inferência de spin e inclinação em um ambiente muito menos complexo, ou pode ser ajustado com um modelo m-ring de componente única no domínio da imagem, em vez do ajuste de duas componentes, uma estreita e uma difusa, que é mais flexível mas também muito mais difícil de estabilizar.
Os próprios autores listam com franqueza o que falta. O conjunto de treinamento, livre de ruído e sem convolução com nenhum feixe instrumental, é irrealista, e o treinamento adicional com imagens ruidosas convoluídas com o feixe nominal do BHEX deve melhorar a robustez em dados reais. Mais dados de treinamento provavelmente mitigarão as falhas menores observadas em algumas imagens do KerrBAM. A capacidade de generalizar, ainda que parcialmente, para instantâneos complexos é descrita como intrigante, mas exige investigação mais sólida para determinar a precisão alcançável e o potencial de integração com métodos que promediam as observações em escalas de tempo longas, o que será inevitável para um alvo variável como Sagitário A*, cujo gás completa uma órbita em questão de minutos.
A recompensa, se o método amadurecer, é uma das medidas mais cobiçadas da astrofísica contemporânea. A rotação de um buraco negro supermassivo é a memória de sua história: ele a acumula ou a perde conforme engole gás de forma ordenada ou caótica e conforme se funde com outros buracos negros ao longo de bilhões de anos. É também, segundo o mecanismo proposto por Roger Blandford e Roman Znajek em 1977, o reservatório de energia que alimenta os jatos relativísticos, como o jato de M87, que se estende por milhares de anos-luz. Até hoje, as estimativas de spin dependem de modelos indiretos, baseados em espectros de raios X ou na comparação entre simulações e imagens borradas. Uma medida direta na geometria do anel de fótons seria de outra natureza, ancorada na própria curvatura do espaço-tempo.
O BHEX, proposto por um consórcio liderado pelo Centro de Astrofísica Harvard-Smithsonian, é o candidato mais avançado para fornecer essas imagens, mas não é o único esforço para estender a interferometria a escalas angulares menores. O artigo cita o conceito de interferometria com o Origins Space Telescope, discutido por Dominic Pesce e colegas em 2019, o programa Capella, que propõe uma rede de pequenos satélites em órbita baixa e foi descrito por Sascha Trippe e colaboradores em 2026, e a expansão do horizonte de imageamento com o telescópio AtLAST, apresentada por Kazunori Akiyama e colegas também em 2026. Qualquer um deles produziria imagens com a mesma dificuldade fundamental, a sobreposição entre os subanéis, e se beneficiaria de um método capaz de separá-los.
Há uma lição metodológica implícita no estudo que se aplica a toda a astronomia na era do aprendizado de máquina. Uma rede neural é tão boa quanto os exemplos que recebeu, e o maior risco não é errar, mas acertar com confiança onde não há nada a acertar. O cuidado dos autores em incluir imagens vazias no treinamento, em filtrar os casos triviais da avaliação, em testar o modelo contra simulações de física diferente e em documentar os vieses sistemáticos encontrados é o que separa uma prova de conceito útil de uma demonstração vistosa. O resultado de NXcorr igual a 0,99 pesa menos, no fim das contas, do que a imagem escura devolvida quando o subanel não existe.
Volte ao fóton do início, aquele que deu meia volta em torno de um abismo e chegou à Terra 55 milhões de anos depois. Ele não sabe nada sobre redes neurais, nem sobre as 111 mil imagens sintéticas, nem sobre as cem tentativas de um otimizador automático. Sabe apenas o caminho que percorreu, e esse caminho está escrito no lugar exato em que ele pousa na imagem, a uma fração de raio gravitacional do seu vizinho que não deu volta nenhuma. Durante quase um século, a relatividade geral afirmou que essa linha existe. Dentro de uma década, um telescópio em órbita talvez a registre. O que o trabalho de Duong, Myhre e Farah sugere é que, quando a foto chegar, já haverá quem saiba ler a entrelinha.