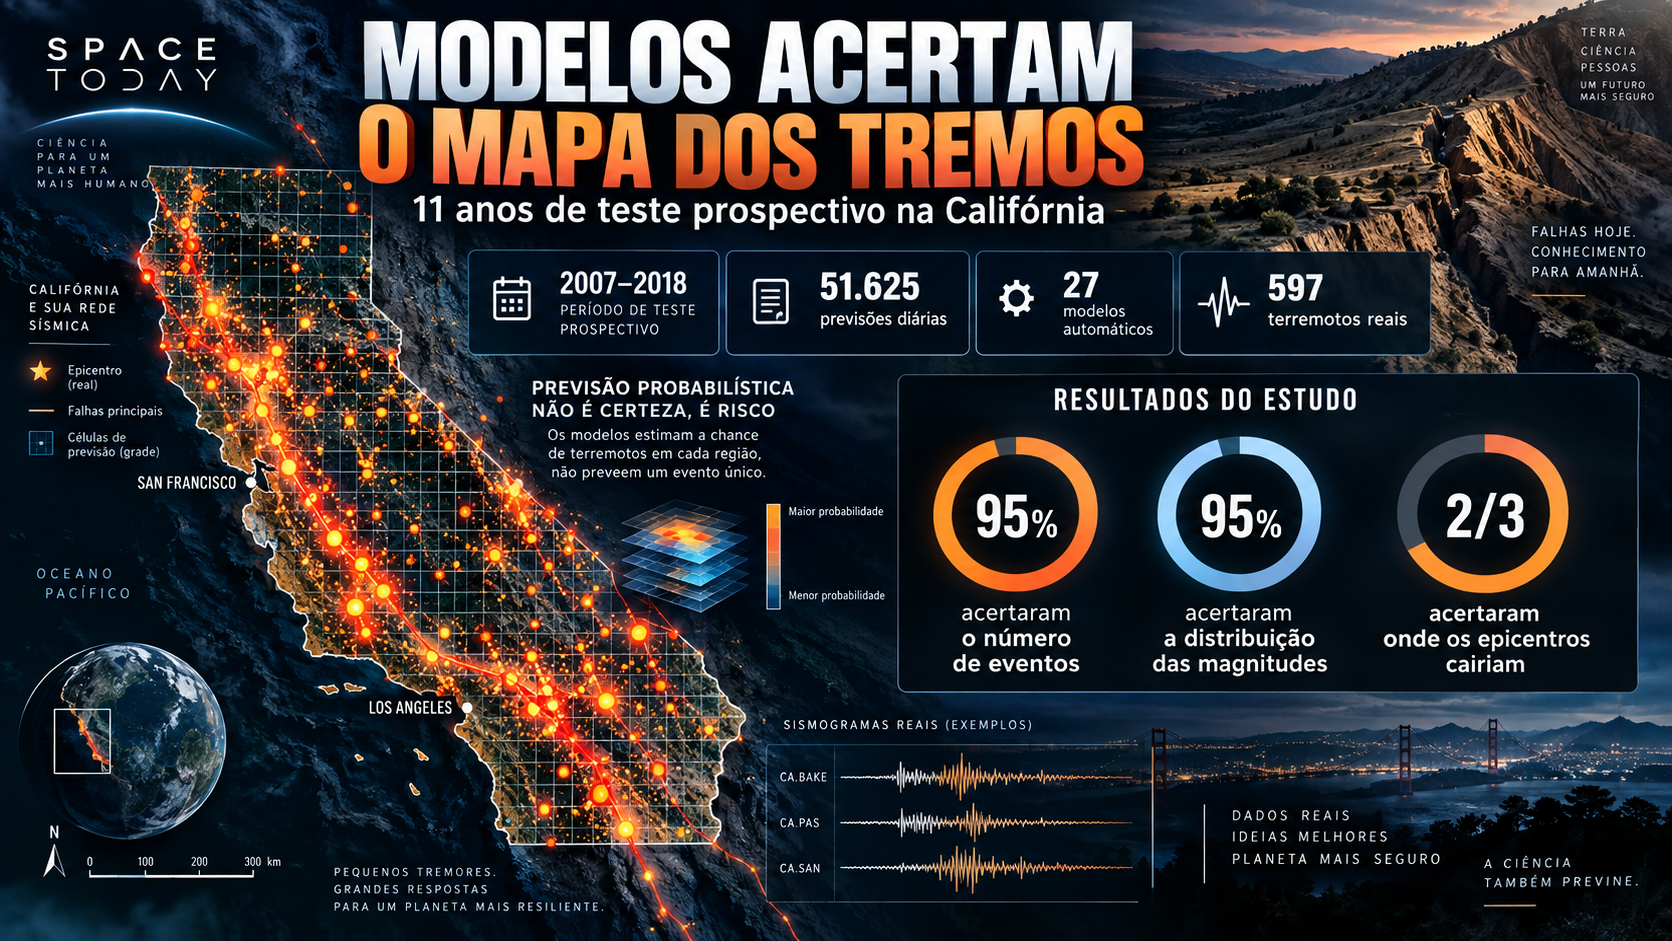
Estudo na Nature Communications confrontou 51.625 previsões diárias, geradas automaticamente por 27 modelos, com os 597 terremotos reais registrados entre 2007 e 2018: 95% dos modelos acertaram o número de eventos, 95% acertaram a distribuição de magnitudes e dois terços acertaram onde os epicentros cairiam.
Todas as noites, à meia-noite em ponto do horário universal, durante onze anos seguidos, um conjunto de programas de computador despertou em servidores na Califórnia e repetiu a mesma rotina. Cada programa leu o catálogo de terremotos registrados até as 23h59m59s do dia anterior, aplicou suas equações e produziu um mapa: milhares de pequenas células cobrindo o estado, cada uma com um número que dizia quantos tremores de magnitude 3,95 ou maior eram esperados ali nas 24 horas seguintes. Ninguém revisava o resultado. Ninguém ajustava os parâmetros. A rotina se repetiu 51.625 vezes entre 1º de agosto de 2007 e 30 de agosto de 2018, enquanto a crosta sob a Califórnia fazia o que sempre fez: rompia quando queria, onde queria, com a força que queria. Agora, um grupo internacional de sismólogos abriu esse arquivo de previsões e o confrontou, dia a dia, com os 597 terremotos que de fato aconteceram.
“Quando vai acontecer o próximo grande terremoto?” é a pergunta que todo sismólogo aprende a ouvir com paciência, porque respondê-la exigiria algo que a ciência nunca conseguiu entregar: a hora, o lugar e a magnitude de um evento futuro, com as respectivas incertezas. Ao longo do século passado, dezenas de estudos revisados por pares anunciaram sinais precursores supostamente capazes de denunciar um grande tremor com antecedência, de variações no nível de água em poços a emissões de gás radônio e anomalias eletromagnéticas. Um trabalho publicado na revista Science em 2023 identificou, nos dados de GPS de 90 grandes terremotos, uma aceleração de deslizamento nas duas horas que antecederam as rupturas. O problema é que quase todos esses resultados nasceram de análises retrospectivas, feitas depois de o terremoto ter ocorrido e sabendo-se onde procurar. Um sinal só vale como ferramenta de previsão quando funciona antes do evento, em dados que ninguém escolheu a dedo.
Foi justamente essa exigência que levou a sismologia a mudar de pergunta. Em vez de perseguir a previsão determinística, uma parte importante da comunidade passou a trabalhar com a previsão probabilística, que não diz quando o terremoto vai acontecer, mas quantifica as chances de que ele aconteça em determinada janela de tempo, em determinada região e acima de determinada magnitude. É a mesma lógica da meteorologia: ninguém sabe se vai chover sobre a sua casa às três da tarde de amanhã, mas uma probabilidade de 70% de chuva informa decisões reais. A diferença é que, no caso dos terremotos, a comunidade científica decidiu que essas probabilidades só mereceriam confiança se fossem submetidas a um teste impiedoso, contra dados que ainda não existiam no momento em que as previsões foram emitidas.
A instituição que encarna essa filosofia chama-se Collaboratory for the Study of Earthquake Predictability, o Colaboratório para o Estudo da Previsibilidade de Terremotos, conhecido pela sigla CSEP. Criado em meados dos anos 2000 a partir do centro de pesquisas sísmicas da Califórnia, o SCEC, e hoje espalhado por centros de teste em vários continentes, o CSEP funciona como um cartório científico. Quem quiser submeter um modelo de previsão precisa definir de antemão todos os parâmetros, a região, as magnitudes, o formato dos resultados e os métodos estatísticos pelos quais aceitará ser julgado. Depois disso, o modelo passa a rodar sozinho em servidores independentes, e seus resultados são comparados com os terremotos que acontecerem dali em diante. Não há como ajustar nada depois de ver os dados, o que elimina os vieses que contaminaram décadas de alegações sobre precursores.
O artigo que acaba de sair na revista Nature Communications, assinado por José A. Bayona e Maximilian J. Werner, da Universidade de Bristol, no Reino Unido, com colegas do Statewide California Earthquake Center, do centro alemão de geociências GFZ, da Universidade de Nevada em Reno e da Universidade de Nápoles Federico II, é o balanço mais completo já feito desse experimento. Os autores pegaram o banco de dados de 51.625 previsões diárias geradas por 27 modelos ao longo de onze anos, selecionaram os 21 modelos que trabalhavam com o limiar de magnitude 3,95 e os submeteram a uma bateria de testes estatísticos validados pela comunidade. O resultado, resumido em três números, dá a medida do que a sismologia já consegue fazer: cerca de 95% dos modelos previram corretamente o número total de terremotos, dois terços acertaram a distribuição espacial dos epicentros e 95% acertaram a distribuição das magnitudes.
Esses números importam porque modelos desse tipo já deixaram o laboratório. Na Itália, na Nova Zelândia e nos Estados Unidos, agências governamentais operam sistemas de Operational Earthquake Forecasting, a previsão operacional de terremotos, que divulgam ao público, em tempo quase real, como o risco sísmico evolui dia após dia, sobretudo depois de um grande tremor, quando as réplicas podem derrubar o que o choque principal apenas trincou. O conceito ganhou corpo depois do terremoto de L’Aquila, na Itália, em 2009, que matou mais de 300 pessoas e levou à condenação, depois revertida, de cientistas acusados de tranquilizar indevidamente a população. A comissão internacional convocada após a tragédia concluiu que a resposta correta não era o silêncio nem a falsa segurança, mas a divulgação responsável de probabilidades calculadas por modelos testados. A questão que ficou aberta foi exatamente a que o novo estudo responde: quanto se pode confiar nesses modelos?
Para entender a resposta, é preciso conhecer as engrenagens dos modelos. Quase todos eles combinam duas leis empíricas descobertas há mais de um século. A primeira é a lei de Omori, formulada em 1894 pelo sismólogo japonês Fusakichi Omori a partir das réplicas do terremoto de Nobi, de 1891, e depois refinada por Tokuji Utsu: o número de réplicas cai com o inverso do tempo decorrido desde o choque principal, de modo que o segundo dia tem aproximadamente metade das réplicas do primeiro, o décimo dia tem um décimo, e assim por diante. A segunda é a relação de Gutenberg–Richter, estabelecida em 1944 por Beno Gutenberg e Charles Richter justamente com dados da Califórnia: para cada redução de uma unidade na magnitude, o número de terremotos cresce cerca de dez vezes. Juntas, essas duas leis descrevem como a energia liberada por uma ruptura se espalha no tempo e na escala de tamanhos.
O modelo que leva essa combinação mais longe é o ETAS, sigla de Epidemic-Type Aftershock Sequence, ou sequência de réplicas do tipo epidêmico, proposto pelo estatístico japonês Yosihiko Ogata em 1988. A palavra “epidêmico” não é figura de linguagem. No ETAS, cada terremoto, grande ou pequeno, é tratado como um indivíduo capaz de “contagiar” a vizinhança, gerando uma prole de novos tremores que, por sua vez, geram os seus próprios descendentes. Uma réplica pode ter réplicas; uma réplica de réplica pode ter mais réplicas ainda. Sobre essa cascata de contágios, o modelo acrescenta uma taxa de fundo, a sismicidade que ocorre espontaneamente, sem gatilho identificável, e que define o nível básico de atividade de cada região.
O outro grande modelo de agrupamento é o STEP, de Short-Term Earthquake Probability, probabilidade de terremoto de curto prazo, apresentado na revista Nature em 2005 por Matthew Gerstenberger e colegas. Foi o primeiro sistema a publicar diariamente, para o público, mapas de probabilidade de tremores para o dia seguinte na Califórnia, e sua marca registrada é estimar a produtividade de cada sequência à medida que os dados chegam, em vez de confiar apenas em valores médios herdados do passado. Entre os 27 modelos do experimento havia várias versões de cada uma dessas duas famílias, com diferenças na forma de suavizar a sismicidade sobre o mapa, no limiar de magnitude usado na calibração e no tratamento da taxa de fundo, o que permitiu aos pesquisadores isolar o efeito de cada escolha de projeto.
O experimento do CSEP, porém, não se limitou a ETAS e STEP. Entre os modelos havia alternativas como o PPE, de Proximity to Past Earthquakes, proximidade a terremotos passados, que distribui probabilidade segundo a distância a eventos anteriores, e o EEPAS, Every Earthquake a Precursor According to Scale, cada terremoto como precursor segundo sua escala, abordagem neozelandesa em que tremores menores anunciam, com meses ou anos de antecedência, a chegada de tremores maiores. As duas abordagens nasceram no instituto de geociências da Nova Zelândia, pelas mãos de David Rhoades e Frank Evison, e até hoje integram o sistema de previsão daquele país, o que faz do experimento californiano também um teste de ideias desenvolvidas do outro lado do Pacífico.
Havia também modelos não paramétricos, que não impõem uma forma matemática fixa às relações entre variáveis e deixam os próprios dados moldar os núcleos de suavização, como o HW-KERNEL, de Agnès Helmstetter e Maximilian Werner, e o GSF, um modelo de Hawkes não paramétrico desenvolvido por estatísticos da Universidade da Califórnia em Los Angeles. E havia os ensembles, ou conjuntos, que combinam dois ou mais modelos em uma única previsão, na esperança de que as forças de um compensem as fraquezas do outro, como já se faz na meteorologia.
Todos eles falavam a mesma língua. A região de teste CSEP-Califórnia, um polígono que envolve o estado e avança sobre partes de Nevada e da Baja California mexicana, foi dividida em 7.682 células de 0,1 grau por 0,1 grau, cada uma com cerca de dez quilômetros de lado. Em cada célula, a magnitude foi fatiada em intervalos de um décimo de unidade, de 3,95 até 8,05 ou mais. O resultado são 391.782 compartimentos espaço-magnitude, e a previsão de um modelo para um dia consiste em preencher cada um deles com o número médio esperado de terremotos. Como os modelos entraram no experimento em datas diferentes, alguns desde 2007, outros em 2012 ou 2016, cada um foi avaliado apenas contra os terremotos do período em que esteve ativo. Nos dias calmos mostrados no artigo, a soma de todos os compartimentos oscilava entre 0,01 e 0,18 terremoto esperado por dia, conforme o modelo.

Do outro lado da balança estavam os terremotos reais. O catálogo abrangente da rede sísmica nacional dos Estados Unidos, a ANSS, registrou na região de teste, entre agosto de 2007 e agosto de 2018, 597 eventos de magnitude 3,95 ou maior com profundidade de até 30 quilômetros. Entre eles estão alguns dos episódios mais marcantes da sismologia californiana recente. Em 10 de janeiro de 2010, um tremor de magnitude 6,5 sacudiu o litoral de Ferndale, no norte do estado. Em 4 de abril daquele ano, domingo de Páscoa, veio o terremoto de El Mayor–Cucapah, de magnitude 7,2, com epicentro no norte da Baja California, a poucas dezenas de quilômetros da fronteira, o maior evento a atingir a Califórnia desde o terremoto de Landers, de magnitude 7,3, em 1992.
Em 26 de agosto de 2012, o Vale Imperial foi tomado pelo enxame sísmico de Brawley, uma sucessão de tremores sem choque principal que um estudo posterior atribuiu à injeção de fluidos em um campo geotérmico vizinho. A lista continua com o terremoto de magnitude 6,8 ocorrido na área de Mendocino, ao largo do norte da Califórnia, em 10 de março de 2014, e com o de South Napa, de magnitude 6,0, que em 24 de agosto de 2014 abalou a região vinícola ao norte de São Francisco e foi o maior a atingir a área da Baía desde Loma Prieta, em 1989.
South Napa guarda uma peculiaridade que o torna um teste à parte. Pela lei de Båth, regra empírica proposta pelo sismólogo sueco Markus Båth em 1965, a maior réplica de um terremoto costuma ter magnitude cerca de 1,2 unidade abaixo da do choque principal, o que para um evento de magnitude 6,0 significaria uma réplica em torno de 4,8. South Napa não produziu nenhuma réplica de magnitude 3,95 ou superior. Foi uma sequência anormalmente improdutiva, e os modelos tiveram de lidar com isso sem saber de antemão que aquele terremoto seria a exceção.

A lógica dos testes é a de um tribunal estatístico. A hipótese de partida é que o modelo é o “gerador” dos dados, isto é, que os terremotos observados poderiam ter saído de um sorteio feito com as probabilidades do modelo. Para verificar isso, em vários dos testes os pesquisadores simulam 10.000 catálogos sintéticos a partir de cada previsão e comparam o catálogo real com essa multidão de mundos possíveis. Se o que aconteceu de verdade cai dentro da faixa central que abriga 95% das simulações, o modelo é considerado consistente com as observações; se cai fora, é rejeitado. Esse tipo de verificação, chamada de teste de consistência, foi aplicada separadamente ao número de terremotos, à localização dos epicentros e à distribuição das magnitudes. Um segundo tipo de teste, o comparativo, mede quanto cada modelo acrescenta de informação em relação a um modelo de referência mais simples.
O primeiro veredito veio da contagem. Na versão clássica do teste de número do CSEP, que assume que a quantidade de terremotos em um período segue uma distribuição de Poisson, a distribuição que descreve eventos raros e independentes, apenas dois modelos, o ETAS-PPE-M2.95 e o STEPJAVA, foram considerados consistentes com o total observado ao longo dos anos. A distribuição de Poisson, porém, tem uma rigidez conhecida: sua variância é igual à média, e ela não acomoda a natureza agrupada dos terremotos, em que longos períodos de quase nada são interrompidos por rajadas de centenas de eventos em poucos dias. É a diferença entre contar carros em uma estrada de fluxo constante e contar carros em uma avenida onde o trânsito vem em ondas. Para dar conta dessa variabilidade, a equipe repetiu o teste com uma distribuição binomial negativa, de variância maior, calibrada com o catálogo histórico da própria Califórnia.
Com essa régua mais realista, o quadro mudou por completo. Dos 21 modelos, 20 forneceram totais estatisticamente compatíveis com o número de terremotos observados. A única exceção foi o KJ-SMOOTHING-V0, que subestimou de forma gritante os 510 eventos registrados nos quase dez anos em que operou. Os autores classificam esse resultado como um marco na pesquisa de previsibilidade sísmica, e as razões são duas. Primeiro, os parâmetros que governam a produtividade de réplicas em cada modelo nunca foram atualizados ao longo de todo o período de avaliação, por mais que a Califórnia tenha mudado sob os pés dos pesquisadores. Segundo, todas as previsões foram geradas automaticamente, nos servidores do CSEP, sem qualquer intervenção humana, o que torna impossível atribuir o sucesso a ajustes feitos de olho nos dados.
Para quem prefere pensar em porcentagens, o estudo traz uma comparação direta. Nove dos 21 modelos, quase a metade, chegaram a totais que diferem em 20% ou menos do número real de terremotos. O STEPJAVA, ao longo de aproximadamente oito anos, previu cerca de 254 tremores de magnitude 3,95 ou maior contra 246 observados, um desvio de apenas 3%. O ETAS-SMOOTHING-V0, presente durante os onze anos completos, previu 678 contra 579 observados, e o STEP, ao longo de cerca de seis anos, previu 398 contra 332, ambos com desvio de 17%. Os autores lembram que cada modelo foi confrontado com um número diferente de terremotos, porque cada um teve sua própria janela de operação, e que os resultados baseados em mais dados são mais indicativos da capacidade real de cada um.

A contagem acumulada ao longo de anos, contudo, esconde o que acontece nos dias que realmente importam, aqueles em que a terra treme forte. Avaliar a previsão dia a dia mostra se os modelos conseguem acompanhar a evolução de uma sequência, e é exatamente depois de um grande terremoto que essa capacidade salva vidas, quando as réplicas ameaçam equipes de resgate e edifícios já comprometidos. Nesse recorte diário, a primeira constatação é desconfortável, mas previsível: nos dias em que ocorreram os terremotos de Ferndale, de El Mayor–Cucapah, de Mendocino e o início do enxame de Brawley, todos os modelos subestimaram o número de tremores. Não poderia ser diferente. Um grande terremoto é, por definição, um evento de baixa probabilidade em qualquer dia específico, a menos que a atividade sísmica já esteja elevada, e nenhum modelo baseado no passado recente tem como antecipar o instante em que a crosta rompe.
A pergunta relevante é quão rápido os modelos se recuperam. No caso de El Mayor–Cucapah, o maior terremoto do banco de dados, a subestimativa persistiu nos dois primeiros dias da sequência, contando o dia do choque principal como dia zero, até que o ETAS-SMOOTHING-V0 e o STEP passaram a capturar as contagens diárias. Em contrapartida, nas duas semanas seguintes ao terremoto de Ferndale, ao enxame de Brawley e aos dois grandes eventos de 2014, mais de 80% dos modelos disponíveis forneceram previsões diárias estatisticamente consistentes com as observações. Mesmo diante de South Napa e sua ausência quase total de réplicas, a maioria dos modelos acertou, porque os intervalos de confiança de suas previsões, ajustados dia após dia pelo decaimento de Omori, acomodaram o número reduzido de eventos.

Por que os dois primeiros dias são tão difíceis? Os autores apontam dois suspeitos. O primeiro é a incompletude de curto prazo do catálogo: logo depois de um grande terremoto, os sismógrafos ficam saturados pela vibração do choque principal e das réplicas maiores, e dezenas de tremores menores passam despercebidos, escondidos na cauda das ondas sísmicas. Modelos calibrados com um limiar de completude fixo acabam alimentados por um catálogo que, naqueles dias, está faltando pedaços, e a produtividade estimada sai distorcida. O segundo suspeito é o uso de parâmetros médios de produtividade de réplicas, calibrados com terremotos de toda a região, que não capturam a diversidade de comportamentos observada de uma falha para outra. Como até o STEP, que estima a produtividade específica de cada sequência à medida que os dados chegam, teve dificuldade com El Mayor–Cucapah, os pesquisadores concluem que aquela sequência foi de fato mais produtiva do que o esperado.
Dessa constatação sai uma lista de recomendações concretas para a próxima geração de modelos: considerar produtividades que variem no espaço, incorporar correções para a incompletude temporária do catálogo, atualizar as previsões assim que um terremoto moderado ou grande acontece, em vez de esperar a meia-noite seguinte, e recalibrar os parâmetros de produtividade com mais regularidade. Os autores sugerem ainda investigar se a produtividade de réplicas pode ser prevista a partir de propriedades mensuráveis da crosta, como o ambiente tectônico, o chamado valor b da relação de Gutenberg–Richter, a profundidade dos hipocentros, a espessura da camada sismogênica, o deslizamento pós-sísmico das falhas e o fluxo de calor, hipóteses levantadas por diversos estudos recentes e que, naturalmente, também precisarão de testes prospectivos.
O enxame de Brawley merece um capítulo à parte, porque nenhum dos modelos foi projetado para lidar com ele. Um enxame sísmico não tem choque principal dominante, e sua evolução temporal não obedece a nenhuma lei simples comparável à de Omori; costuma ser governado por processos invisíveis ao catálogo, como a migração de fluidos ou o deslizamento lento e silencioso de uma falha. O enxame de 2012 durou um mês inteiro, mas concentrou seus nove maiores tremores, todos de magnitude 3,95 ou superior, logo no primeiro dia, incluindo dois eventos transcorrentes de magnitude 5,3 ou mais e dois de falha normal de magnitude 4,3 ou mais. Os modelos trataram aquilo como uma sequência comum de réplicas e previram que a contagem diária cairia de um máximo de cinco para um máximo de um terremoto ao longo dos 15 dias seguintes, o que acabou se mostrando estatisticamente compatível com o que se observou.
Houve nesse episódio um dado curioso. O modelo de referência do estudo, o HKJ-ADAPTIVE-M2, que não muda com o tempo e simplesmente suaviza a sismicidade histórica sobre o mapa, mostrou-se, entre julho e outubro de 2012, tão informativo quanto a maioria dos modelos de dia seguinte. Os autores veem nisso um apoio ao uso de modelos simples como primeira aproximação para descrever a evolução de enxames, ao mesmo tempo que reconhecem que componentes específicos para esse tipo de sismicidade, sensíveis a transientes assísmicos, teriam muito a acrescentar à previsão operacional. Na outra ponta do espectro, em duas semanas de calmaria escolhidas ao acaso em janeiro de 2018, mais de 80% dos modelos previram corretamente a taxa de fundo, oferecendo intervalos que iam de zero a um terremoto por dia.
Saber quantos terremotos vão acontecer é metade da história; saber onde é a outra metade. Depois de um grande evento, as réplicas se concentram em torno da ruptura, e um modelo capaz de delimitar bem essa zona permite direcionar vistorias, interdições e equipes de emergência. Para avaliar esse aspecto, a equipe recorreu a um teste espacial binário. Para cada célula do mapa, a previsão de um modelo implica uma probabilidade de que pelo menos um terremoto ocorra ali, e o teste simplesmente pergunta, nos dias em que houve tremores, quão verossímil era o padrão de células “ativadas” à luz das probabilidades do modelo. Essa verossimilhança é confrontada com a de 10.000 catálogos simulados, gerando um quantil espacial, representado pela letra grega zeta. Se zeta é maior que 0,05, a distribuição espacial prevista e a observada são estatisticamente indistinguíveis naquele dia.
Como os modelos foram avaliados em centenas de dias ativos, o estudo vai além da aprovação dia a dia e examina a distribuição de todos os quantis. Se um modelo fosse de fato o gerador dos dados, seus quantis deveriam se espalhar uniformemente entre zero e um, e a curva ordenada deles seguiria a diagonal de um gráfico de calibração. Desvios contam histórias diferentes: uma curva abaixo da diagonal denuncia previsões espacialmente suavizadas demais, que espalham probabilidade por áreas amplas como uma fotografia fora de foco; uma curva acima da diagonal revela previsões localizadas demais ou simplesmente erradas, que apostam tudo em poucas células e deixam o resto do mapa a descoberto. A área entre a curva e a diagonal, chamada A no artigo, resume o tamanho do desvio, e um teste de Kolmogorov–Smirnov diz se ele é estatisticamente significativo.
Por essa régua, 15 dos 21 modelos, cerca de 71%, geraram previsões consistentes com a distribuição espacial dos 597 epicentros. Entre os mais bem calibrados estão o ETAS-ADAPTIVE-M3, com área de apenas 0,03, o ETAS-PPE-M2 e o STEPJAVA, ambos com 0,04, os modelos não paramétricos HW-KERNEL-M2 e HW-KERNEL-M3, também com 0,04, e os conjuntos ETAS-HW-KERNEL-M2 e ETAS-HW-KERNEL-M3, com 0,06 e 0,04. Os autores consideram esse desempenho notável por uma razão simples: nenhum dos métodos de suavização espacial foi atualizado ao longo do período de avaliação. Os mapas de probabilidade que acertaram onde a Califórnia tremeria foram construídos com regras fixadas no momento em que cada modelo entrou no experimento e nunca mais tocadas.

Os mapas acumulados da primeira semana de cada grande sequência mostram, com cores, o que a estatística diz em números. O ETAS-SMOOTHING-V0, o mais antigo dos modelos ETAS do experimento, obteve quantis espaciais altíssimos, de 0,91, 0,99, 0,67 e 0,81, respectivamente em Ferndale, El Mayor–Cucapah, Brawley e Mendocino, mas por um motivo pouco lisonjeiro: suas previsões eram tão suavizadas que atribuíam probabilidades semelhantes a vastas áreas, enquanto os terremotos reais se concentravam em um núcleo muito menor. O STEP cometeu o erro oposto. Em Ferndale, El Mayor–Cucapah e Brawley, obteve quantis de 0,05, 0,00 e 0,16, sinal de excesso de confiança espacial: o modelo apostava que os tremores aconteceriam em um punhado de células e deixava o restante com probabilidades centenas ou milhares de vezes menores. Como a escala de cores dos mapas é logarítmica, cada degrau de tom representa um fator de dez.

No meio do caminho entre o borrão e a aposta cega ficaram os modelos adaptativos. Durante a sequência de Mendocino, em 2014, o ETAS-ADAPTIVE-M2, o HW-KERNEL-M2 e o conjunto ETAS-HW-KERNEL-M2 obtiveram quantis de 0,38, 0,80 e 0,53, valores que indicam um equilíbrio efetivo entre precisão e acurácia espacial. O segredo está nos núcleos de suavização de largura variável: onde há muitos terremotos, o núcleo se estreita e desenha detalhes finos; onde há poucos, ele se alarga e evita falsas certezas. O HW-KERNEL usa um núcleo de lei de potência com largura ajustável, e o ETAS-ADAPTIVE adota um núcleo de lei de potência para terremotos gatilho de magnitude inferior a 5,5 e um núcleo anisotrópico, alongado ao longo da falha, para eventos maiores. Modelos presos a funções isotrópicas fixas, como o ETAS-SMOOTHING-V0 e o STEP, tiveram os piores desempenhos espaciais.
A prova mais limpa de que o detalhe da suavização faz diferença veio de dois irmãos quase idênticos. O ETAS-SMOOTHING-V1 difere do V0 apenas nos parâmetros de suavização espacial, com um núcleo de largura menor. Entre janeiro de 2013 e julho de 2016, o V1 superou o V0 de forma estatisticamente significativa, demonstrando que um procedimento de suavização comparativamente mais fino se traduz em previsões melhores. Há ainda a lição dos núcleos anisotrópicos, que atribuem mais probabilidade às regiões alinhadas com a direção da falha principal. O ETAS-ADAPTIVE imita esse comportamento suavizando a posição das réplicas dos três primeiros dias para prever as seguintes, e o STEP e o STEPJAVA são formulados para trocar para um núcleo anisotrópico assim que surge sismicidade desencadeada suficiente.
O problema é que esse “suficiente” exigiu mais dados do que havia disponível até mesmo depois de El Mayor–Cucapah, o que explica os mapas do STEP largamente circulares durante a maior sequência do banco de dados. Os autores sugerem alimentar o núcleo espacial do STEP com produtos que o USGS já gera minutos após um terremoto, como os mapas de intensidade ShakeMap, os modelos de fonte finita que reconstroem a geometria da ruptura, os dados geodésicos de deformação do solo e os mapas de falhas preexistentes. A ideia é simples: se a falha que rompeu já é conhecida, não faz sentido esperar que as réplicas desenhem o seu traçado antes de apostar nele.
O terceiro teste de consistência trata das magnitudes, uma dimensão de interesse crescente por causa da demanda por estimativas de tremor do solo após um grande evento. Aqui o resultado foi quase unânime. Pelo teste de magnitude do CSEP, todos os 21 modelos produziram distribuições de frequência-magnitude compatíveis com a observada. Como esse teste tem pouca sensibilidade para distinguir duas amostras vindas da mesma distribuição, a equipe aplicou também o teste de Kolmogorov–Smirnov de duas amostras, e novamente todos os modelos passaram, com uma única exceção: o STEPJAVA. Entre os mais consistentes figuram o ETAS-SMOOTHING-V1, com valor-p de 0,99, o ETAS-ADAPTIVE-M3, com 0,92, e o ETAS-PPE-M2, com 0,89, seguidos pelos conjuntos ETAS-HW-KERNEL, com 0,80 e 0,69, e pelos não paramétricos HW-KERNEL, com 0,66 e 0,45.
O tropeço do STEPJAVA tem uma explicação instrutiva. Sua distribuição de magnitudes previstas se afasta da curva de Gutenberg–Richter típica e se eleva na faixa entre 6,0 e 7,0, aproximando-se de uma distribuição do tipo “característica”, em que uma falha teria preferência por rupturas de determinado tamanho. Acontece que nenhum terremoto de magnitude 6,0 ou maior ocorreu na região do STEPJAVA, menor que a região completa de teste, durante o tempo em que o modelo esteve ativo, e a aposta em eventos grandes ficou sem respaldo. A conclusão geral dos autores é que, para prever magnitudes na Califórnia, o mais seguro é usar uma distribuição de Gutenberg–Richter com corte suave, com valor b médio de 1,0 e magnitude de canto de 8,0, um parâmetro que estabelece o tamanho a partir do qual a frequência dos terremotos cai mais depressa do que a lei prevê, refletindo o limite físico das falhas da região.

Passar nos testes de consistência é condição necessária, mas não diz qual modelo é melhor. Para isso, a equipe usou uma medida da teoria da informação chamada ganho de informação binário por célula ativada, ou IGPA, que compara cada modelo de dia seguinte com o HKJ-ADAPTIVE-M2. Esse modelo de referência não é um adversário fraco. Criado por Agnès Helmstetter, Yan Kagan e David Jackson em 2007, ele suaviza de forma adaptativa a sismicidade registrada e, ao longo de quinze anos de testes prospectivos, superou todos os outros modelos invariantes no tempo que previam terremotos moderados a grandes na Califórnia. Confrontar os modelos dinâmicos com ele responde a uma pergunta precisa: quanto se ganha, de fato, ao incorporar a dependência temporal? Um IGPA positivo significa que o modelo dinâmico distribuiu melhor suas apostas pelas células onde os terremotos de fato caíram; um valor negativo significa que teria sido melhor ficar com o mapa estático.
Como os modelos entraram em operação em momentos diferentes, a comparação foi feita em seis janelas sucessivas. Entre agosto de 2007 e janeiro de 2009, com 69 terremotos em 47 células e apenas três modelos disponíveis, o STEP superou os concorrentes com um ganho de cerca de 1,25 sobre a referência. Entre janeiro de 2009 e setembro de 2010, período que abrigou Ferndale e El Mayor–Cucapah, com 214 terremotos em 89 células, o STEP e o ETAS-SMOOTHING-V0 foram os mais informativos, com ganhos de quase 5,85, o STEP mais hábil em Ferndale e suas réplicas, o ETAS-SMOOTHING-V0 ligeiramente melhor durante a sequência mexicana. Entre setembro de 2010 e julho de 2012, com 81 terremotos em 58 células, o STEPJAVA, recém-chegado ao experimento, liderou com ganho de aproximadamente 2,12, enquanto o KJ-SMOOTHING-V0 amargou uma perda de 0,66.
A janela de julho a outubro de 2012, com apenas 27 terremotos em 15 células, foi dominada pelo enxame de Brawley. O STEP e o ETAS-SMOOTHING-V1 obtiveram os maiores ganhos, de 0,81 e 0,58, e o KJ-SMOOTHING-V0 afundou em uma perda de 3,96, mas nenhum dos ganhos positivos foi estatisticamente significativo, o que confirma que o modelo de referência valeu tanto quanto os dinâmicos durante o enxame. Entre janeiro de 2013 e julho de 2016, com 131 terremotos em 81 células, o STEP já havia sido desativado e dez modelos novos tinham entrado no experimento; os conjuntos ETAS-HW-KERNEL-M2 e ETAS-HW-KERNEL-M3 lideraram, com ganhos de cerca de 4,16 e 4,05, e, depois do terremoto de Mendocino, os modelos mais recentes se destacaram enquanto os mais antigos, como o KJ-SMOOTHING-V0, o ETAS-SMOOTHING-V0 e o ONEDAY-BAYESIAN, ficaram entre os menos informativos.
Na última janela, de outubro de 2016 a agosto de 2018, com 38 terremotos em 33 células e 15 modelos em disputa, o ETAS-PPE-M2, o GSF-ANISOTROPIC e o ETAS-PPE-M2.95 obtiveram ganhos de 1,91, 1,90 e 1,67, e o KJ-SMOOTHING-V0, mais uma vez, fechou a lista com perda de 0,42. Apesar do número reduzido de células ativadas nesse intervalo, a presença simultânea de quinze modelos tornou a comparação especialmente reveladora sobre a capacidade de cada um de prever a sismicidade de fundo, aquela que acontece longe das grandes sequências e que responde pela maior parte dos dias de um sistema operacional.

Lida em sequência, essa cronologia conta a história de uma ciência em progresso. O STEP e o STEPJAVA foram os modelos mais informativos entre 2007 e 2012; a partir de 2013, versões mais recentes do ETAS, como o ETAS-ADAPTIVE e o ETAS-PPE, e os não paramétricos HW-KERNEL e GSF-ANISOTROPIC assumiram a liderança. Os autores interpretam isso como evidência de que os sismólogos estão produzindo previsões cada vez mais informativas, seja por usar dados de maior resolução, melhores técnicas de suavização espacial ou métodos não paramétricos mais sofisticados. Parte do mérito pode estar na própria rede de monitoramento: a modernização e a expansão da ANSS desde o início da década de 2010 deram aos modelos mais novos localizações e magnitudes mais bem determinadas do que as disponíveis para seus antecessores.
Um detalhe aparentemente menor reforça essa leitura. Vários modelos existiam em duas versões, uma calibrada com terremotos a partir de magnitude 2 e outra a partir de magnitude 3, e as versões alimentadas com eventos menores saíram-se ligeiramente melhor. O ETAS-PPE-M2 obteve ganhos um pouco maiores que seu irmão ETAS-PPE-M3 entre 2013 e 2018, e o ETAS-ADAPTIVE-M2 registrou um ganho de 0,30 sobre o ETAS-ADAPTIVE-M3. A melhora é modesta, mas aponta na direção de uma das fronteiras mais promissoras da área: os novos catálogos de alta resolução, produzidos com aprendizado de máquina e técnicas de correlação de formas de onda, que registram muitas vezes mais terremotos minúsculos do que os catálogos tradicionais e podem carregar informação útil sobre o que a crosta fará em seguida.
O capítulo dos conjuntos trouxe lições contraditórias. Os conjuntos ETAS-HW-KERNEL-M2 e M3, que combinam um modelo ETAS adaptativo com um núcleo não paramétrico, estiveram entre os mais informativos de 2012 a 2018 e superaram seus modelos de origem, ainda que nem sempre com significância estatística. Já os ONEDAY-BAYESIAN e ONEDAY-SEQ-BAYESIAN, que pesam seus componentes pelo desempenho individual de cada um, não conseguiram superar o ETAS-SMOOTHING-V1, que fazia parte da própria combinação. A recomendação é combinar modelos atribuindo pesos que maximizem a habilidade do conjunto como um todo, e não a de cada parte. O contraste com a escala global é intrigante: o modelo GEAR1, que combina sismicidade suavizada com taxas de deformação medidas por geodésia, superou em testes prospectivos cada um de seus componentes isolados, o que sugere que a diversidade dos dados combinados importa tanto quanto o método de combinação.
Nem todos os modelos saem bem na fotografia, e o artigo não esconde os problemas. O par KJ-SMOOTHING-V0 e KJ-SMOOTHING-V1 apresentou dificuldades em capturar o número de terremotos em qualquer escala. Enquanto o V0 subestimou os eventos acumulados em quase uma década, o V1 fez o oposto, com uma taxa de longo prazo de cerca de 1,6 milésimo de terremoto de magnitude 4,95 ou maior por dia por quilômetro quadrado, quando a taxa publicada para o modelo é de cerca de 3,5 décimos de milionésimo, uma diferença de mais de três ordens de grandeza que aponta para um erro nos códigos que geram as previsões. Os autores pedem uma revisão técnica desses programas e fazem questão de lembrar que as iniciais KJ homenageiam Yan Kagan e David Jackson, dois dos nomes mais influentes da sismologia estatística, cuja contribuição versões corrigidas desses modelos honrariam.
Outro caso instrutivo é o PPE-BACKGROUND-M2, o componente de fundo variável no tempo que alimenta o ETAS-PPE-M2. Sozinho, ele superestimou em cerca de 44% a taxa de longo prazo observada, provavelmente porque foi calibrado em um período de atividade excepcionalmente alta na Califórnia, que incluiu Loma Prieta, de magnitude 6,9, em 1989, a tríade Joshua Tree, Landers e Big Bear, de magnitudes 6,1, 7,3 e 6,2, em 1992, e Hector Mine, de magnitude 7,1, em 1999. A escolha da janela de calibração, portanto, pesa tanto quanto as equações. O mesmo raciocínio ajuda a explicar por que modelos alimentados com catálogos históricos longos, como o STEP e o STEPJAVA, calibrados com dados desde 1932, e o ETAS-SMOOTHING-V0, com dados desde 1898, acertaram tão bem os totais: integrar registros históricos com catálogos instrumentais modernos e assumir componentes de fundo variáveis no tempo aparece, na conclusão dos autores, como receita para modelos consistentes com o número total de terremotos.
As implicações mais imediatas do estudo recaem sobre os sistemas operacionais já em funcionamento. Na Itália, o Instituto Nacional de Geofísica e Vulcanologia opera desde 2013 um sistema que combina, de modo bayesiano, versões locais do ETAS, do STEP e de um terceiro modelo, o ETES, e que publica todos os dias à meia-noite, e imediatamente após qualquer tremor de magnitude local 3,5 ou maior, previsões de terremotos de magnitude 4,0 ou superior para a semana seguinte. É, segundo os autores, o único sistema do mundo com esse grau de regularidade.
Em uma década de avaliações prospectivas, o desempenho foi bom, com duas exceções: a sequência de Emilia, em 2012, de magnitude 6,1, em que o STEP produziu previsões espacialmente localizadas demais, exatamente o defeito agora quantificado na Califórnia, e a sequência de Amatrice–Norcia, de 2016 e 2017, de magnitude 6,6, em que os modelos subestimaram o número de eventos nos primeiros dias por causa da incompletude do catálogo, problema contornado na época com uma correção empírica aplicada às previsões. Os dois tropeços italianos, lidos lado a lado com os resultados californianos, apontam para as mesmas fraquezas estruturais: núcleos espaciais rígidos demais e catálogos que ficam cegos justamente nas horas mais críticas.
Para o sistema italiano, cujos parâmetros não são atualizados desde abril de 2009, a receita californiana se traduz em três sugestões: desenvolver e testar versões do STEP com distâncias de suavização maiores ou maior peso para o núcleo anisotrópico, criar versões do ETAS com núcleos espaciais adaptativos e taxas de fundo dependentes do tempo, e recalibrar tudo com mais frequência. Na Nova Zelândia, o sistema operado pela agência Earth Sciences New Zealand divulga previsões ao público desde 2010, depois do terremoto de Darfield, de magnitude 7,1, e passou pelos testes duríssimos de Christchurch, em 2011, de magnitude 6,2, que matou 185 pessoas, e de Kaikōura, em 2016, de magnitude 7,8. O modelo neozelandês é um conjunto que cobre várias escalas de tempo, com o ETAS e o STEP para horas a semanas, o EEPAS para meses a anos e o PPE para décadas.
As avaliações prospectivas neozelandesas mostram um quadro misto. Nos seis meses após Darfield, janela que incluiu Christchurch, o ETAS foi consistente com o número total de terremotos, mas uma versão de dia seguinte do PPE o subestimou significativamente. Nos três meses após Kaikōura, o STEP e o ETAS superestimaram a taxa observada, e o PPE voltou a subestimar. O excesso do ETAS após Kaikōura foi atribuído em parte a discrepâncias de recalibração de magnitude entre sistemas de aquisição de dados, mas os autores sugerem, à luz dos resultados da Califórnia, que o uso de um componente de fundo invariante no tempo nessa versão do ETAS também pode explicar o desvio. Quanto ao PPE, o resultado californiano é oposto ao neozelandês, já que a versão do modelo para a Califórnia superestimou os totais em 44%, e a recomendação é reavaliar todos os modelos da Nova Zelândia com as ferramentas abertas pyCSEP e floatCSEP.
Nos Estados Unidos, a previsão operacional fica a cargo do USGS e funciona em dois níveis. Um sistema automatizado cobre terremotos em território americano com base no modelo de Reasenberg e Jones, de 1989, que combina a lei de Omori–Utsu com a relação de Gutenberg–Richter e trata todas as réplicas como filhas diretas do choque principal, ignorando que uma réplica pode desencadear outras. Para superar essa limitação, o USGS desenvolve uma nova versão do ETAS com parâmetros regionalizados. Um sistema manual, acionado em sequências domésticas particularmente complexas e em terremotos internacionais com mais de cem mortes estimadas, usa uma versão global do ETAS que considera a sismicidade desencadeada de ordem superior, a variabilidade aleatória da produtividade e a incompletude temporária do catálogo, mas carece de uma taxa de fundo, o que pode subestimar o perigo de longo prazo em regiões muito ativas.
A Califórnia conta ainda com o UCERF3-ETAS, que acopla o ETAS a um componente de longo prazo baseado nas falhas conhecidas e na estatística do rebote elástico, mas seu custo computacional é tão alto que o modelo só é executado sob demanda, como ocorreu durante a sequência de Ridgecrest, de magnitude 7,1, em 2019. Os autores recomendam ao USGS calibrar o novo ETAS com sismicidade cada vez menor, considerar métodos espaciais adaptativos e não paramétricos e componentes de fundo dependentes do tempo, comparar o novo modelo com versões do ETAS cujos parâmetros são atualizados regularmente, confrontar o ETAS global com outros modelos globais e comparar, de forma pseudoprospectiva, o desempenho do UCERF3-ETAS com o dos modelos de dia seguinte. É um roteiro de trabalho para anos, extraído inteiramente do confronto com os dados.
Talvez o legado mais duradouro do estudo esteja no que ele deixa aberto ao público. O banco de dados completo, com mais de 50.000 previsões em formato HDF5, está disponível no repositório Zenodo sob licença Creative Commons, acompanhado de código documentado e de um tutorial de acesso, e as previsões de cada modelo também podem ser baixadas no site do CSEP. Os testes foram feitos com a ferramenta de código aberto pyCSEP, e um pacote de reprodutibilidade revisado por pares, hospedado na plataforma Code Ocean, permite a qualquer pesquisador refazer cada figura e cada cálculo do artigo. Com isso, quem desenvolver um novo modelo de previsão para a Califórnia terá uma régua pronta: poderá compará-lo com onze anos de previsões reais, classificar combinações inéditas e inventar métricas para aspectos ainda não avaliados.
Os próprios autores reconhecem os limites do que foi testado. Os modelos avaliados descrevem a sismicidade por meio de compartimentos que fornecem apenas valores médios das distribuições esperadas, e esses valores médios não capturam toda a incerteza de uma previsão. Foi por isso que a equipe recorreu a várias métricas, da binomial negativa aos testes binários, para minimizar o viés resultante. Ainda assim, o balanço final é inequívoco: 95% dos modelos capturaram o número acumulado de terremotos, mais de dois terços forneceram previsões espacialmente consistentes e 95% acertaram a distribuição de magnitudes. Trata-se, na avaliação da equipe, de um apoio sólido ao uso desse tipo de modelo em sistemas públicos de previsão operacional.
Para um leitor no Brasil, país assentado no interior de uma placa tectônica e poupado dos grandes terremotos, a discussão pode parecer distante. Mas o que está em jogo aqui é um método, e esse método é universal. É a mesma lógica que a meteorologia levou décadas para consolidar, com previsões probabilísticas avaliadas contra o tempo que de fato fez, e a mesma que hoje se aplica à previsão do clima espacial, quando centros de monitoramento estimam a probabilidade de uma explosão solar ou de uma tempestade geomagnética e depois verificam, com os mesmos tipos de pontuação, quanto acertaram. Uma ciência amadurece quando aceita ser julgada pelo futuro, e a sismologia acaba de mostrar, com onze anos de dados que ninguém pôde manipular, que já está nesse estágio.
A crosta terrestre continua sem avisar quando vai romper, e o estudo não finge o contrário: no dia em que El Mayor–Cucapah sacudiu a fronteira entre o México e a Califórnia, nenhum dos modelos tinha a menor ideia do que estava por vir. O que mudou é o que acontece depois, nas horas, dias e semanas em que a Terra ainda treme e as pessoas precisam decidir onde dormir, que prédios interditar e por onde mandar os socorristas. Para essas decisões, já existem modelos que erram pouco, e agora se sabe quais são, quanto erram e por quê. Os autores encerram o artigo com a esperança de que resultados assim ajudem a construir uma cultura sísmica em que as comunidades vulneráveis deixem de perguntar apenas “quando virá o próximo grande?” e passem a perguntar “quão confiáveis são as previsões que recebemos?”. À meia-noite seguinte, em algum servidor da Califórnia, os programas voltarão a acordar para responder.