
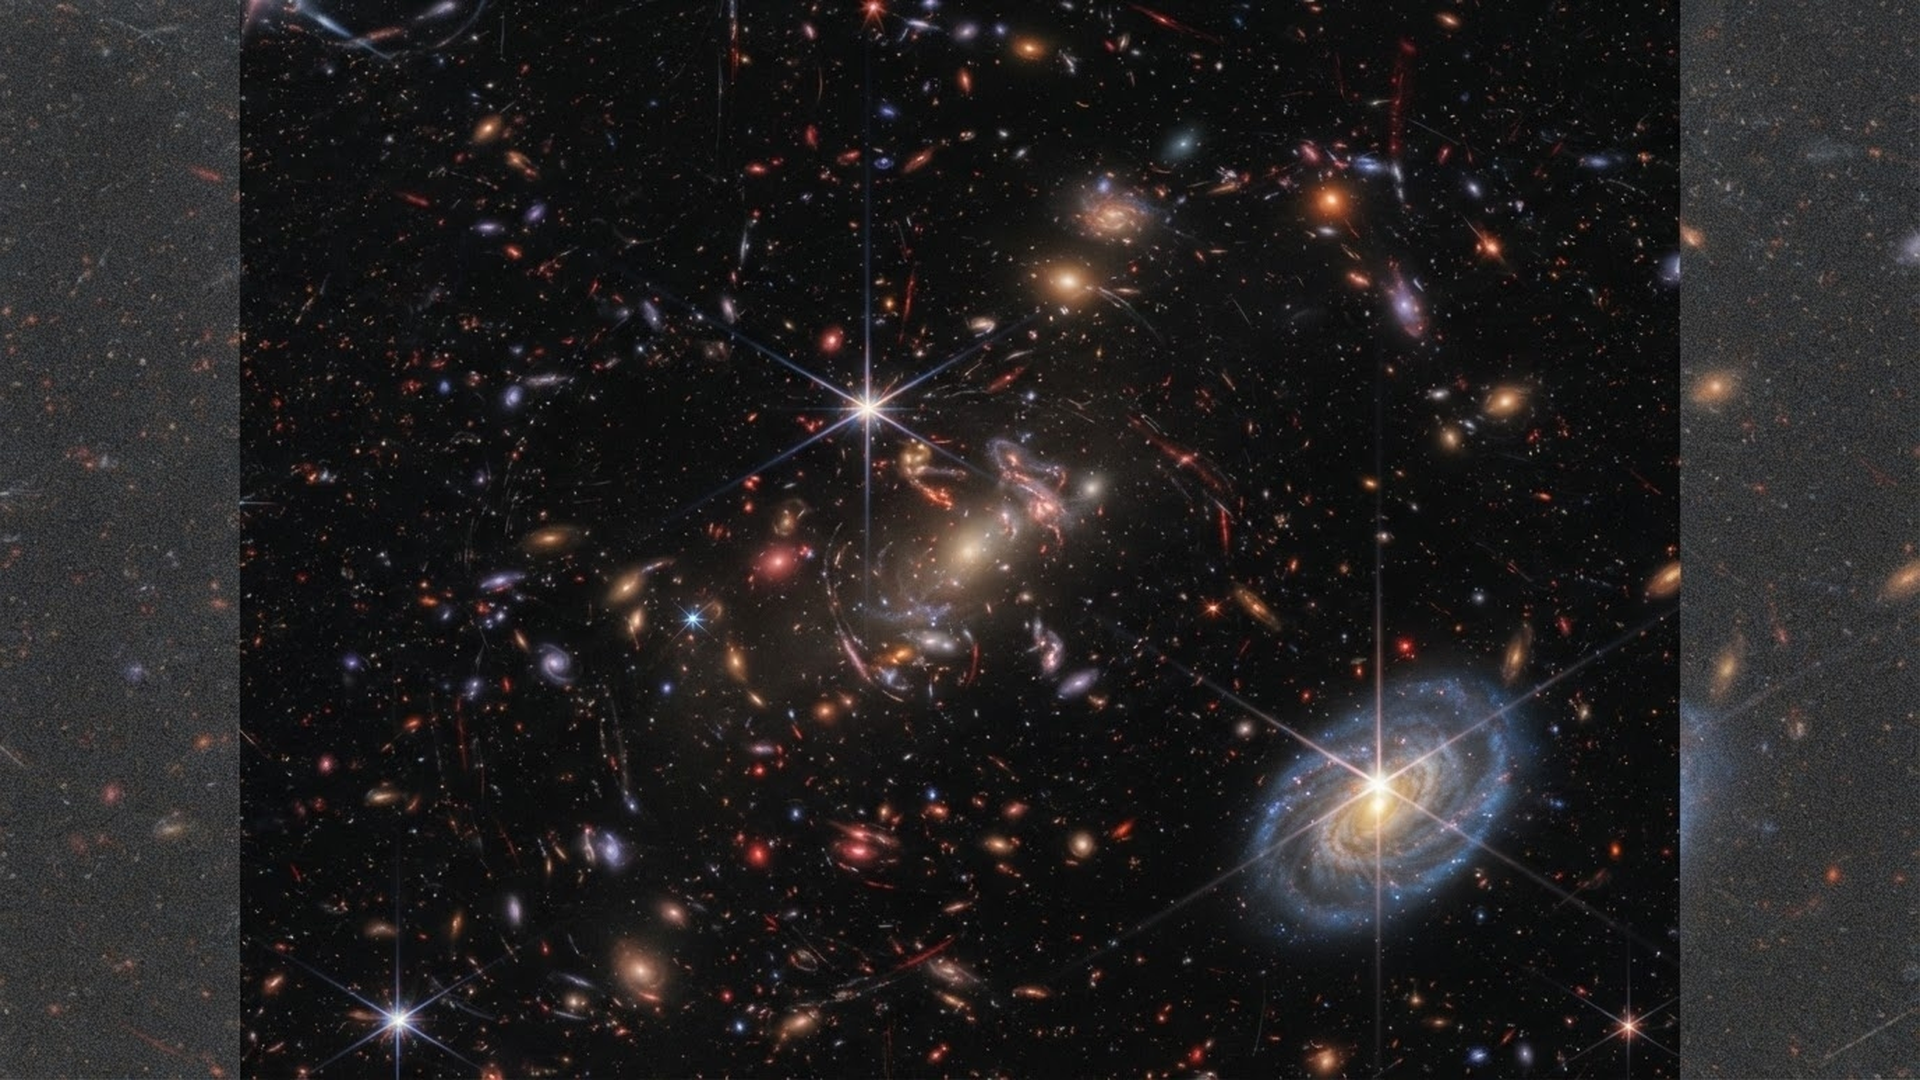
Treinado apenas com exposições reais do telescópio, o algoritmo ASTERIS enxerga fontes 2,5 vezes mais fracas sem distorcer a fotometria e encontra 162 candidatas a galáxias dos primeiros 550 milhões de anos no campo mais profundo já observado, sem um segundo a mais de tempo de telescópio
Toda imagem astronômica guarda um segredo incômodo: ela contém mais universo do que conseguimos enxergar. Abaixo da granulação cinzenta do ruído, diluídas entre pixels que oscilam ao acaso, existem galáxias inteiras cuja luz chegou ao detector, foi registrada e, ainda assim, permaneceu invisível para qualquer algoritmo de busca. No campo mais profundo já observado pelo Telescópio Espacial James Webb, um grupo de pesquisadores da Universidade Tsinghua, em Pequim, acaba de provar isso de forma contundente. Sem pedir um único segundo adicional de tempo de telescópio, eles reanalisaram dados públicos com um método novo de inteligência artificial e encontraram 162 candidatas a galáxias dos primeiros 550 milhões de anos do cosmos, cerca de três vezes mais do que os mesmos dados haviam revelado até então. A luz sempre esteve lá. O que faltava era uma maneira melhor de olhar.

Crédito: Guo et al. 2026, Science 392, eady9404 (Fig. 4A) · © 2026 The Authors / AAAS
O trabalho saiu na edição de 30 de abril de 2026 da revista Science, depois de aparecer on-line em 19 de fevereiro, e tem como primeiros autores Yuduo Guo, Hao Zhang e Mingyu Li, que dividem o crédito principal em partes iguais. A coordenação coube a Qionghai Dai, Zheng Cai e Jiamin Wu, todos da Tsinghua, com a participação de pesquisadores do Instituto Kavli para a Física e a Matemática do Universo, da Universidade de Tóquio, e do Observatório Astronômico Nacional do Japão.
O método recebeu o nome ASTERIS, sigla em inglês para Astronomical Self-supervised Transformer-based Denoising, algo como remoção de ruído astronômico autossupervisionada e baseada em transformers, a família de redes neurais que também sustenta os grandes modelos de linguagem. O termo denoising designa a tarefa de separar, dentro de uma imagem, o sinal verdadeiro das flutuações aleatórias que o contaminam. O resultado central cabe em uma frase: o algoritmo empurra o limite de detecção para objetos uma magnitude inteira mais fracos, mantendo 90% de completude e 90% de pureza, sem borrar as estrelas nem alterar as medidas de brilho.
Uma magnitude pode parecer pouco para quem não convive com a escala logarítmica dos astrônomos, mas o salto é grande. Cada degrau de magnitude corresponde a um fator de 2,512 em brilho, de modo que avançar de 31 para 32 significa enxergar fontes duas vezes e meia mais tênues. No sistema AB adotado no artigo, números maiores indicam objetos mais fracos, e a magnitude 31 já está tão além do alcance humano que qualquer comparação cotidiana soa pálida: o Webb detecta rotineiramente galáxias dez bilhões de vezes mais fracas do que a estrela mais fraca visível a olho nu em uma noite escura. O limite de detecção é a fronteira onde o sinal de uma fonte deixa de se distinguir da agitação estatística do fundo, e deslocar essa fronteira em uma magnitude equivale a ampliar o volume de universo acessível a um telescópio.
O custo de conquistar essa magnitude pela força bruta ilustra por que o resultado importa. O próprio artigo faz a conta para o Webb: elevar o limite de detecção a cinco sigmas no filtro F115W, uma banda larga centrada em 1,15 micrômetro, de 31 para 32 magnitudes exigiria ampliar o tempo total de exposição de quatro dias para cerca de um mês. A razão está na matemática do ruído. Quando as flutuações de cada pixel são independentes, combinar M exposições melhora a relação sinal-ruído apenas pela raiz quadrada de M, e para ganhar um fator de 2,5 em sensibilidade é preciso multiplicar o tempo por mais de seis. Em um observatório disputado por milhares de propostas, onde cada hora é leiloada entre programas que vão de exoplanetas a aglomerados de galáxias, um mês inteiro em um único campo é um luxo quase impensável.
O ruído que impõe esse limite não tem uma única origem. Parte dele nasce no próprio instrumento, no sopro eletrônico dos detectores durante a leitura. Parte vem do céu: a luz zodiacal espalhada pela poeira do Sistema Solar, o brilho difuso da nossa própria galáxia e, no caso dos telescópios terrestres, a atmosfera. E uma parcela irredutível é a estatística dos próprios fótons, que chegam de forma discreta e aleatória, como pingos de chuva em um telhado. Espelhos maiores e detectores mais silenciosos atacam as duas primeiras fontes, e foi isso que a engenharia fez ao longo de um século. Contra a luz zodiacal e os fundos galácticos, porém, nenhum avanço de hardware ajuda: eles estão no caminho da luz, e qualquer telescópio, em qualquer órbita, os registra junto com o alvo.
A ferramenta clássica para enfrentar esse fundo é a coadição, conhecida em inglês como coaddition ou stacking, o empilhamento de muitas exposições do mesmo campo. A ideia é simples: se o sinal de uma galáxia aparece no mesmo lugar em todas as imagens enquanto o ruído muda de uma para outra, a média de todas realça o que é constante e dilui o que é aleatório. Para evitar que raios cósmicos, pixels saturados ou defeitos do detector contaminem a média, as observações profundas são feitas com pequenos deslocamentos entre as exposições, uma técnica chamada dither, e a combinação final rejeita os valores discrepantes. Foi assim que nasceram os campos profundos do Hubble a partir de 1995, e é assim que o Webb constrói suas imagens mais profundas.
Há uma premissa escondida nessa receita, e é nela que a equipe de Tsinghua encontrou espaço para avançar. A fórmula da raiz quadrada vale quando o ruído de cada pixel é independente do pixel vizinho e da exposição seguinte. Nos dados reais, isso raramente acontece. A função de espalhamento pontual, ou point spread function, abreviada PSF, a figura que descreve como o telescópio borra uma fonte pontual, distribui a luz por vários pixels e os torna correlacionados. O fundo do céu tem estrutura espacial. Os efeitos instrumentais deixam padrões. O ruído astronômico carrega, portanto, uma assinatura interna, e aquilo que tem estrutura pode, em princípio, ser aprendido e removido. A coadição melhora a relação sinal-ruído, mas deixa sobre a mesa um ganho que ninguém estava recolhendo.
Tentativas anteriores de recolher esse ganho esbarraram em compromissos ruins. Suavizar a imagem com um núcleo de convolução, uma espécie de média ponderada entre pixels vizinhos, realmente ajuda a revelar fontes fracas, mas sacrifica a resolução espacial e borra justamente os detalhes que os astrônomos querem medir. Métodos de aprendizado profundo supervisionados precisam de pares de imagens ruidosas e limpas para treinar, e na astronomia esses pares só existem de forma sintética ou por meio de exposições curtas pareadas com exposições longas. Dados simulados nunca reproduzem toda a complexidade do ruído real, e exposições longas de referência consomem o mesmo tempo de telescópio que se queria economizar. A base de treinamento, nesse caminho, é escassa por construção.
A saída veio de uma família de técnicas chamadas autossupervisionadas, em inglês self-supervised, que dispensam a imagem limpa de referência. O marco dessa linha é o Noise2Noise, proposto em 2018 por Jaakko Lehtinen e colegas: uma rede neural aprende a transformar uma versão ruidosa de uma cena em outra versão ruidosa da mesma cena. Como o ruído das duas é independente, a única coisa que a rede consegue prever de forma consistente é o sinal comum, e ela acaba aprendendo a estimá-lo sem jamais ter visto uma imagem perfeita. Aplicados à astronomia, esses métodos melhoravam o aspecto visual das imagens, mas eram avaliados pela relação sinal-ruído global, uma métrica que não diz se as fontes fracas foram de fato recuperadas. Alguns produziam artefatos e apagavam objetos reais em imagens que pareciam limpas.
O ASTERIS estende essa lógica do plano para o volume. Em vez de operar sobre uma única imagem coadicionada, ele recebe a pilha inteira de exposições de um mesmo campo, alinhadas com precisão astrométrica no mesmo sistema de coordenadas celestes, e trata cada conjunto de pixels como um voxel, um elemento de volume cujas duas primeiras dimensões são as coordenadas no céu e a terceira é a sequência das exposições. A rede neural que percorre esse cubo, uma U-Net tridimensional, combina camadas convolucionais, especializadas em padrões locais, com um mecanismo de atenção, ou attention, o componente que está no coração dos transformers e que permite relacionar regiões distantes do cubo, capturando correlações que uma convolução, limitada ao seu campo receptivo, não alcançaria. O algoritmo entra no fluxo de trabalho depois da redução padrão dos dados e antes da identificação das fontes.

Crédito: Guo et al. 2026, Science 392, eady9404 (Fig. 1) · © 2026 The Authors / AAAS
O treinamento segue a receita autossupervisionada com uma exigência concreta: dezesseis exposições alinhadas do mesmo campo. Elas são divididas em dois conjuntos independentes de oito, um de entrada e outro de alvo, que compartilham a mesma expectativa de sinal, mas carregam realizações independentes de ruído. A rede aprende a estimar, a partir do conjunto de entrada, aquilo que o conjunto alvo tem em comum com ele. A função de perda que guia esse aprendizado combina dois termos: o erro quadrático médio entre a coadição da entrada e a do alvo, chamado de perda média, e o erro absoluto médio entre exposições individuais correspondentes, a perda por quadro. A equipe testou várias combinações e descobriu que essa dupla reduz o ruído de fundo, preserva sinais fracos que de outro modo se perderiam e diminui os falsos positivos. Uma vez treinado, o modelo processa qualquer conjunto de oito exposições do mesmo instrumento sem precisar de novos dados de referência.
Os dados que alimentaram esse aprendizado vieram de cinco programas públicos do Webb com a câmera NIRCam: o GLIMPSE, dois programas do levantamento JADES, o JEMS e um levantamento de bandas médias do aglomerado Abell 2744, cobrindo filtros do F070W ao F480M, este último uma banda média centrada em 4,80 micrômetros. As exposições foram reduzidas com a versão 1.15.1 do pipeline de calibração científica do Webb, a cadeia de software que converte os dados brutos em imagens calibradas, alinhadas com catálogos publicados e empilhadas em cubos tridimensionais. O conjunto de treinamento foi fatiado em 120 mil recortes, ou 60 mil pares, cada um com oito exposições de 128 por 128 pixels. Foram treinados modelos separados para os filtros de comprimento de onda curto, abaixo de 2,5 micrômetros, e longo, a partir desse valor. A convergência chegou em cerca de dez iterações, aproximadamente 26 horas de computação.
Uma decisão de projeto define o caráter do método: o ASTERIS só toca na parte fraca da imagem. Antes do processamento, cada cubo é dividido por um limiar de três desvios-padrão acima do fundo. Os pixels acima de 3σ, que pertencem a estrelas e galáxias brilhantes detectadas com folga, são temporariamente retirados, combinados pela mediana e reinseridos intactos na imagem final. Os pixels iguais ou abaixo de 3σ, onde o ruído domina e onde se escondem as fontes marginais, são os únicos que passam pela rede neural. A escolha preserva a faixa dinâmica original sem criar descontinuidades de fluxo e concentra toda a capacidade de aprendizado da rede justamente na região em que ela faz diferença. É como um restaurador que trabalha apenas nas sombras de um quadro, deixando as luzes exatamente como o pintor as deixou.

Crédito: Guo et al. 2026, Science 392, eady9404 (resumo gráfico) · © 2026 The Authors / AAAS
O artigo dedica tanto esforço à régua quanto à rede. Em vez de avaliar o resultado pela aparência das imagens ou pela relação sinal-ruído global, a equipe montou um protocolo que mede o que interessa a um astrônomo na prática: a relação sinal-ruído fotométrica de cada fonte, a completude, a pureza, a fidelidade da PSF e a exatidão fotométrica. Completude, ou completeness, é a fração das fontes reais que o método consegue detectar; pureza, ou purity, é a fração das detecções que correspondem a fontes reais. Um algoritmo agressivo pode inflar a primeira ao custo da segunda, inventando objetos onde só há ruído, e um algoritmo tímido faz o contrário. O chamado F-score combina as duas em um único número, e foi com esse conjunto de métricas que o ASTERIS foi confrontado com os concorrentes.
O teste controlado usou fontes simuladas injetadas em ruído real. A matéria-prima veio do programa GLIMPSE, que acumulou 168 exposições com deslocamentos em um único apontamento no filtro F115W, na direção do aglomerado de galáxias Abell S1063. As imagens foram reamostradas para uma escala de 0,04 segundo de arco por pixel, e uma região de 128 por 128 pixels sem fontes serviu de fundo. Sorteando conjuntos de oito entre as 168 exposições disponíveis, um universo de cerca de 6 quatrilhões de combinações possíveis, os pesquisadores geraram 2 mil realizações independentes de fundo e injetaram 25 fontes pontuais isoladas em cada uma, somando 50 mil objetos sintéticos com brilhos distribuídos entre as magnitudes 27,5 e 31,5 segundo uma lei de potência cúbica. O modelo usado nesse teste havia sido treinado em quatro outros programas, de modo que nunca tinha visto aquele campo.
Na mesma arena entraram os métodos consagrados e os rivais de aprendizado de máquina: a coadição com rejeição de valores discrepantes, a suavização gaussiana, os filtros BM3D e BM4D, o Neighbor2Neighbor e o próprio Noise2Noise, este implementado sobre a arquitetura Restormer, semelhante à usada no ASTERIS. As fontes foram extraídas de todas as imagens com o mesmo programa, o Source Extractor, e com configuração idêntica, para que a comparação fosse justa. Os histogramas de pixels do ASTERIS saíram consistentemente mais estreitos, sinal de um desvio-padrão de ruído menor, e o número de detecções verdadeiras, maior. Medida em aberturas circulares de 0,14 segundo de arco de raio, que capturam cerca de 80% do fluxo da PSF nesses dados do Webb, a sensibilidade a cinco sigmas do Noise2Noise superou a da coadição, e a do ASTERIS superou a do Noise2Noise.
Os números de completude e pureza mostram a distância entre os dois. No nível de 90% de completude, o Noise2Noise aprofundou o limite de detecção em apenas 0,1 magnitude em relação à coadição; o ASTERIS, em cerca de 1,0 magnitude. Em 90% de pureza, a vantagem cresceu: mais de 1,5 magnitude sobre a coadição e 1,0 magnitude sobre o Noise2Noise, o que indica uma redução simultânea dos falsos positivos. Pelo F-score fixado em 0,9, o ganho de profundidade foi de aproximadamente 1,7 magnitude sobre a coadição e 1,4 sobre o concorrente neural. Traduzindo para fluxo, 1,7 magnitude significa fontes quase cinco vezes mais fracas identificadas com a mesma confiabilidade. Os pesquisadores repetiram o exercício em condições menos controladas, com um campo maior e as fontes brilhantes mascaradas, mais próximas de uma observação real, e encontraram ganhos semelhantes.

Crédito: Guo et al. 2026, Science 392, eady9404 (Fig. 2) · © 2026 The Authors / AAAS
Ganhar profundidade não valeria nada se o preço fosse distorcer o que se mede. Por isso a equipe examinou o perfil radial da PSF produzido por cada método e aplicou um teste estatístico de Kolmogorov-Smirnov para compará-los. Entre o ASTERIS e a coadição, o valor-p foi de 0,9, ou seja, nenhuma diferença estatisticamente detectável: as estrelas saem do algoritmo com a mesma nitidez com que entraram. Para o Noise2Noise, o mesmo teste deu um valor-p abaixo de 0,05, que os autores interpretam como degradação da resolução. A fotometria também passou no exame: não houve viés sistemático nas medidas de brilho das 50 mil fontes simuladas, e a precisão para as fontes fracas melhorou ligeiramente em relação à coadição. O resultado se mostrou ainda robusto à ordem em que as exposições são apresentadas à rede.
O veredito final, porém, só poderia vir de dados reais, e a equipe tinha o experimento ideal à mão. As 168 exposições do GLIMPSE podem ser combinadas em uma imagem ultraprofunda que funciona como gabarito: tudo o que aparece nela existe mesmo. Os pesquisadores separaram oito exposições independentes do treinamento, cada uma com 837,5 segundos, e perguntaram quantas fontes do gabarito seriam recuperadas a partir delas. Em um campo denso, próximo de fontes brilhantes, onde o fundo estruturado atrapalha tanto a detecção quanto a medida de fluxo, o Source Extractor encontrou 168 objetos na imagem profunda. A coadição convencional das oito exposições recuperou 50 deles. O ASTERIS, com as mesmas oito exposições e a mesma configuração do extrator, recuperou 93, quase o dobro, e os fluxos medidos nas fontes em comum acompanharam os da coadição ao longo da linha de identidade, sem qualquer tendência.

Crédito: Guo et al. 2026, Science 392, eady9404 (Fig. 3) · © 2026 The Authors / AAAS
O passo seguinte revelou algo que nem a imagem de gabarito sabia. Quando o ASTERIS foi aplicado às 168 exposições completas, o número de fontes detectadas subiu para 229, 35% acima do que os métodos padrão extraem do mesmo conjunto. Dito de outro modo, o campo mais profundo que aquele programa conseguiu produzir ainda escondia dezenas de objetos. Os autores verificaram a mesma conclusão em dados de outro programa do Webb, o levantamento de bandas médias do Abell 2744, e a lição é a mesma: existe ciência nova à espera dentro de dados que já foram coletados, calibrados e publicados, sem necessidade de uma hora adicional de telescópio nem de qualquer melhoria de hardware. Os servidores do Mikulski Archive for Space Telescopes guardam milhares de horas de exposições que poderiam passar pelo mesmo tratamento.
Fontes pontuais fracas não são o único alvo. Estruturas extensas de baixo brilho superficial, como os discos estelares estendidos e os braços externos difusos de galáxias espirais, costumam se dissolver no ruído mesmo em imagens profundas. Para avaliar o ganho nesse regime, a equipe recorreu ao índice de similaridade estrutural, o SSIM, uma métrica nascida na engenharia de imagens que mede quanto uma imagem preserva a estrutura de outra tomada como referência. Em uma galáxia espiral observada no filtro F090W, a coadição de oito exposições alcançou SSIM de 0,37 em relação à imagem profunda; o ASTERIS, com as mesmas oito exposições, chegou a 0,67. Os braços espirais, que na coadição eram uma mancha granulada, reapareceram como estrutura reconhecível.

Crédito: Guo et al. 2026, Science 392, eady9404 (Fig. 3, G a I) · © 2026 The Authors / AAAS
O exemplo mais eloquente é um arco de lente gravitacional em F115W, a imagem distorcida e esticada de uma galáxia distante cuja luz é curvada pela massa de um aglomerado em primeiro plano. Dentro dos contornos de três sigmas, o SSIM subiu de 0,59 na coadição para 0,81 com o ASTERIS, e o arco, antes fragmentado em ilhas desconexas, voltou a ser uma estrutura contínua, como na imagem de 168 exposições. Um grupo de galáxias fracas e difusas em F444W, o filtro mais vermelho da NIRCam, mostrou a mesma transformação: o que era um borrão de ruído com meia dúzia de pontos duvidosos virou um conjunto de fontes nítidas, em posições coincidentes com as da imagem profunda. Nenhuma dessas estruturas foi inventada pela rede; todas estavam no gabarito.

Crédito: Guo et al. 2026, Science 392, eady9404 (Fig. 3, J a L) · © 2026 The Authors / AAAS

Crédito: Guo et al. 2026, Science 392, eady9404 (Fig. 3, M a O) · © 2026 The Authors / AAAS
Restava saber se um método treinado no espaço funcionaria no chão, onde a atmosfera impõe um borrão variável, o chamado seeing, e o céu brilha muito mais no infravermelho próximo. O teste usou o Telescópio Subaru, o espelho de 8,2 metros do Japão no cume do Mauna Kea, no Havaí, com a câmera MOIRCS na banda Ks, centrada em 2,15 micrômetros. Aplicado diretamente, o modelo treinado com o Webb produziu alguns falsos positivos, uma advertência de que o ruído de cada instrumento tem personalidade própria. A equipe então treinou um modelo dedicado com dados de três programas do Subaru e repetiu o experimento: oito exposições de apenas 3 segundos cada, confrontadas com uma coadição profunda de 2.088 segundos do mesmo campo. O ASTERIS recuperou as fontes fracas que a coadição das oito exposições curtas não mostrava. Como o treinamento é autossupervisionado, adaptar o método a um novo telescópio não exige nenhuma imagem limpa de referência, apenas exposições suficientes do próprio instrumento.

Crédito: Guo et al. 2026, Science 392, eady9404 (Fig. 3, P a R) · © 2026 The Authors / AAAS
Com o método validado, os autores o apontaram para o problema que mais mobilizou a astronomia nos últimos anos: as primeiras galáxias do universo. Desde 2022, o Webb vem encontrando galáxias em épocas cada vez mais remotas, incluindo duas confirmadas espectroscopicamente em redshift 14, quando o cosmos tinha cerca de 300 milhões de anos, e em quantidades maiores do que os modelos teóricos previam. O palco escolhido foi o JADES Origins Field, ou JOF, um pequeno retalho de céu na constelação da Fornalha que recebeu do levantamento JADES a imagem mais profunda já feita pelo telescópio, em 14 filtros do F090W ao F444W. Estudos anteriores haviam identificado ali uma população de candidatas com redshift entre 9 e 15, algumas confirmadas por espectroscopia, e as mais fracas delas tinham magnitude absoluta no ultravioleta em repouso de −17.
Identificar essas galáxias depende de uma técnica chamada quebra de Lyman, ou Lyman break. O hidrogênio neutro espalhado pelo meio intergaláctico absorve toda a luz ultravioleta com comprimento de onda menor que o da linha Lyman-alfa, em 1.215,6 angstroms, cortando de forma abrupta o espectro de uma galáxia distante. Para redshift 9 ou mais, a expansão do universo arrasta essa borda para o infravermelho próximo, e a galáxia passa a aparecer nos filtros mais vermelhos enquanto desaparece nos mais azuis. É o chamado dropout, a fonte que some de um lado do espectro. Uma quebra forte, ou a ausência de detecção abaixo de duas sigmas nos filtros azuis, é a assinatura primária de uma galáxia de alto redshift. O problema é que galáxias de redshift baixo exibem uma quebra parecida em 0,4 micrômetro no referencial de repouso, a quebra de Balmer, e, quando o brilho da fonte roça o nível do ruído, uma pode ser confundida com a outra.
O ASTERIS alterou os dois lados dessa equação. A profundidade a cinco sigmas do JOF, que nos trabalhos anteriores variava de 30,3 a 30,8 magnitudes conforme o filtro, passou a variar de 30,9 a 31,6. Aplicando aos dados tratados os mesmos critérios de seleção dos estudos prévios, a equipe identificou 162 candidatas a galáxias com redshift fotométrico de 9 ou mais, cerca de três vezes o número anterior. As mais fracas têm magnitude absoluta ultravioleta próxima de −16, uma magnitude além do que se conhecia. O método recuperou todas as galáxias do campo já confirmadas por espectroscopia e todas as candidatas apontadas por mais de um trabalho independente, o que afasta a hipótese de uma amostra inchada por artefatos, e 75% das suas candidatas nunca haviam sido reportadas. A completude da seleção foi aferida com simulações de injeção de fontes.

Crédito: Guo et al. 2026, Science 392, eady9404 (Fig. 4) · © 2026 The Authors / AAAS
A busca seguiu à risca os procedimentos dos estudos que a precederam, para que a comparação fosse honesta. A imagem de detecção foi construída pela coadição das imagens tratadas pelo ASTERIS nos filtros F277W, F356W e F444W, e as fontes foram extraídas com o Source Extractor. A fotometria usou aberturas circulares de 0,1 segundo de arco de raio em todos os filtros, com correções baseadas nos perfis da PSF, e as incertezas foram estimadas a partir de aberturas aleatórias em regiões vazias do céu. Os redshifts fotométricos vieram do ajuste de distribuições espectrais de energia com o código EAZY e um conjunto de espectros-modelo, e as propriedades físicas das candidatas foram inferidas com o BEAGLE, um código bayesiano de análise de galáxias. Nada nessa cadeia é novo; o que mudou foi a qualidade das imagens que entram nela.
Os autores atribuem a triplicação a dois efeitos. O primeiro é direto: fontes de magnitude 31 a 32, antes marginais, tornam-se detecções. O segundo é mais sutil e talvez mais valioso: a melhora na relação sinal-ruído dos filtros azuis resolve ambiguidades no redshift fotométrico. O caso da candidata de identificação 13333 ilustra isso. Na coadição, ela era um ponto hesitante perto do limite de detecção, com relação sinal-ruído abaixo de 2 nos filtros F090W e F115W e sem redshift determinável. Com o ASTERIS, a profundidade desses dois filtros cresceu mais de uma magnitude, a ausência de sinal neles ficou estatisticamente significativa, e a distribuição espectral de energia passou a apontar com clareza para um redshift fotométrico de 10,14, uma galáxia vista quando o universo tinha menos de 500 milhões de anos.
O exemplo oposto é igualmente revelador e mostra que o método não funciona apenas como um amplificador de candidatas. A fonte 40011 tinha, na coadição, relação sinal-ruído abaixo de 2 no filtro F090W, compatível com uma quebra de Lyman, e um redshift fotométrico estimado em 9,45. Depois do ASTERIS, a detecção em F090W subiu para uma relação sinal-ruído de 4,7: a galáxia estava lá, emitindo no filtro em que uma fonte de redshift 9 deveria ser invisível, e o melhor ajuste despencou para redshift 2,08. Uma intrusa de baixo redshift foi desmascarada. Nessa fronteira, onde cada candidata disputa tempo precioso de espectroscopia para confirmação, eliminar impostoras vale tanto quanto encontrar novas.
A amostra também chegou a territórios que os trabalhos anteriores no mesmo campo não haviam alcançado. Quatro candidatas receberam redshifts fotométricos entre 16 e 22,5, épocas em que o universo tinha entre cerca de 250 e 150 milhões de anos. A fonte 10461 é o caso exemplar: ela some no filtro F200W e em todos os mais azuis, aparece a partir do F277W e simplesmente não existe na imagem coadicionada. A distribuição de probabilidade do redshift derivada pelo ASTERIS favorece com folga a solução de redshift 17,08 sobre a alternativa de baixo redshift. Os próprios autores tratam esses objetos como o que são: candidatas fotométricas, e só a espectroscopia com o NIRSpec poderá confirmar ou derrubar cada uma delas. Se ao menos uma se sustentar, estará entre as galáxias mais antigas já identificadas.

Crédito: Guo et al. 2026, Science 392, eady9404 (Fig. 5) · © 2026 The Authors / AAAS
Com 162 candidatas em mãos, a equipe construiu a função de luminosidade ultravioleta em repouso, a contagem de quantas galáxias existem por volume de espaço em cada faixa de brilho, para duas fatias de tempo cósmico: 125 objetos entre redshift 9 e 12, com mediana de 9,51, e 33 objetos entre 12 e 16, com mediana de 12,97. Em ambas, a função se estende uma magnitude além dos trabalhos anteriores, e a inclinação do seu extremo fraco, o parâmetro que mede quão depressa as galáxias tênues se multiplicam, saiu íngreme: −2,45 com incerteza de 0,03 na primeira fatia e −2,28 com incerteza de 0,02 na segunda. Esses valores apontam para densidades de galáxias fracas, com magnitude absoluta a partir de −16, maiores do que as previstas por modelos teóricos, e tudo isso medido em um volume de céu bem menor do que o usado em estudos anteriores.

Crédito: Guo et al. 2026, Science 392, eady9404 (Fig. 6) · © 2026 The Authors / AAAS
A inclinação do extremo fraco não é um detalhe técnico. Ela decide quem fez o trabalho pesado da reionização, a época em que a radiação das primeiras fontes luminosas voltou a ionizar o hidrogênio neutro que preenchia o universo. Se galáxias anãs, individualmente modestas mas enormemente numerosas, dominarem a contagem, elas podem ter fornecido a maior parte dos fótons ionizantes. Uma inclinação tão acentuada quanto a medida pelo ASTERIS reforça esse cenário e pressiona os modelos de formação de galáxias a produzir mais sistemas pequenos nas primeiras centenas de milhões de anos. Os autores ajustaram as contagens com uma função de Schechter e calcularam os volumes efetivos com simulações de injeção e recuperação de fontes, mas o resultado se apoia em redshifts fotométricos, e a confirmação espectroscópica dessas galáxias tênues ainda está por vir.
O artigo é franco sobre as condições de contorno do método. A arquitetura exige um número par de exposições de entrada, e a escolha de oito foi um compromisso entre a estratégia padrão dos levantamentos profundos do Webb, que costumam usar nove posições de deslocamento, e o consumo de memória da rede. Uma variante treinada para quatro exposições funciona, mas o ganho cai de 1,0 para 0,7 magnitude em 90% de completude, e menos fontes fracas são identificadas, reflexo da menor quantidade de informação espaço-temporal disponível. Os autores desaconselham com ênfase a tentação de duplicar exposições artificialmente para completar o número exigido: isso viola a premissa de ruído independente e, nos testes, elevou a taxa de falsos positivos.
Quando há mais exposições do que a rede aceita, a solução é agrupá-las em subconjuntos e coadicionar cada um: 24 exposições, por exemplo, viram oito pacotes de três, que então alimentam o modelo. Situações sem múltiplo exato, como 21 exposições na versão de oito ou 7 na versão de quatro, também foram testadas. O custo computacional é modesto para os padrões atuais. Processar um cubo de oito exposições com 1.650 por 1.650 pixels leva cerca de 18,1 segundos em quatro unidades de processamento gráfico com 40 gigabytes de memória cada, e o treinamento completo de um modelo consome cerca de 26 horas. O código em Python está em um repositório público, a versão usada no artigo foi arquivada no Zenodo junto com dados de demonstração e com os modelos pré-treinados para a NIRCam do Webb e para a MOIRCS do Subaru, e os dados do Webb podem ser obtidos no arquivo MAST pelos identificadores dos programas.
A conta inversa à que o artigo apresenta ajuda a dimensionar o resultado. Pela regra da raiz quadrada, ganhar uma magnitude de profundidade exigiria multiplicar o tempo de exposição por cerca de seis. Um levantamento que já consumiu 100 horas de Webb passaria a valer, em profundidade efetiva, algo próximo de 600 horas, sem que o telescópio saísse do lugar. Aplicado aos grandes campos legados do Hubble e do Webb, e também aos levantamentos que virão, como o Telescópio Espacial Nancy Grace Roman, com um campo de visão cerca de cem vezes maior que o do Hubble, e o Observatório Vera C. Rubin, que fotografará o céu do hemisfério sul centenas de vezes ao longo de dez anos, acumulando as pilhas de exposições de que o método se alimenta, o ASTERIS oferece um atalho para uma profundidade que a engenharia sozinha levaria décadas a conquistar.
Há motivos para entusiasmo e para cautela em doses parecidas. O histórico da remoção de ruído por redes neurais inclui imagens limpíssimas que escondiam objetos apagados ou inventados, e o mérito do grupo de Tsinghua está em ter construído um protocolo de avaliação que mede detecção real, e não aparência. Ainda assim, cada nova aplicação a um instrumento ou a um regime de brilho diferente precisará passar pelo mesmo escrutínio, com gabaritos profundos e injeção de fontes, antes que suas detecções sejam aceitas como catálogo. A comunidade também vai querer ver as 162 candidatas confrontadas com a espectroscopia, o único juiz capaz de converter um redshift fotométrico em uma distância medida. O método muda a economia da observação profunda; não dispensa a verificação.
Há algo de poético no fato de que a descoberta não exigiu um fóton a mais. As 162 galáxias do JADES Origins Field atravessaram mais de 13 bilhões de anos, foram colhidas pelo espelho dourado do Webb e dormiram em um arquivo público até que alguém ensinasse uma rede neural a reconhecer a textura do ruído e a separá-la do sinal. A próxima fronteira da astronomia talvez não esteja em um espelho maior ou em uma órbita mais distante, e sim nos dados que já temos, lidos por olhos mais pacientes do que os nossos. O universo primitivo continua escondido na granulação cinzenta das imagens mais profundas já feitas. Agora sabemos que ele está lá, e sabemos como procurá-lo.